資料來源#
- FastContext: Training Efficient Repository Explorer for Coding Agents
- SWE-Pruner Pro: The Coder LLM Already Knows What to Prune
摘要#
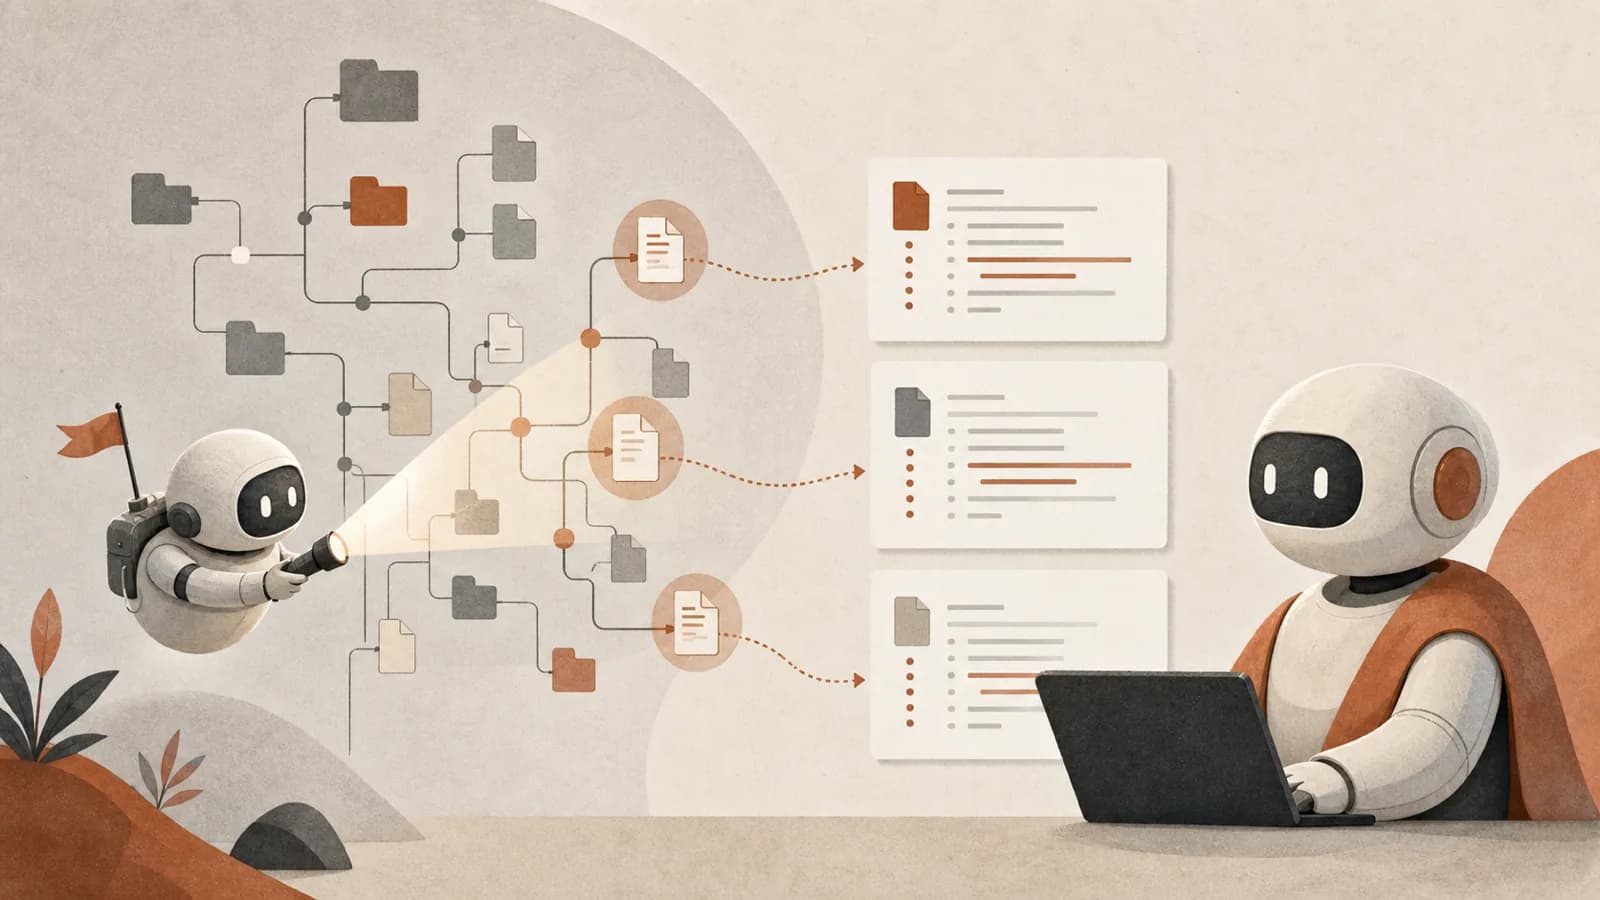
在多數程式碼代理程式中,同一個模型同時負責探索儲存庫(讀取檔案、以 glob 搜尋路徑、以 grep 尋找符號來定位相關程式碼)和解決任務(編輯、執行測試、產生修補程式)。探索成本高昂,也會污染上下文:每次探索性讀取與搜尋都會留在求解代理程式的對話紀錄中,消耗 token 預算,還會讓無關片段掩蓋真正的決策點。FastContext(Shaoqiu Zhang 等人,Microsoft CoreAI + Shanghai Jiao Tong University,2026 年 6 月)主張,儲存庫探索應成為一級、可分離、可訓練的元件——按需呼叫的專責子代理程式,以唯讀方式平行呼叫工具,並只回傳精簡的檔案與行號引用作為聚焦上下文。整合至 Mini-SWE-Agent 後,端對端解題率最高提升 5.5%,同時主代理程式的 token 用量最多降低 60%,額外成本極低。系統實例請見 FastContext。
瓶頸:探索主導求解代理程式的執行軌跡#
研究先分析 SWE-bench Multilingual 上全部 300 條 GPT-5.4-high Mini-SWE-Agent 執行軌跡,並將工具呼叫分類為讀取、搜尋、編輯、測試及其他:
- 讀取 + 搜尋 = 17.72 次工具使用輪次中的 9.96 次(56.2%),佔主代理程式總 token 的 46.5%。這部分 token 既是直接推論成本,也形成求解代理程式必須一路攜帶的上下文。
- 探索是編輯前漫長的循序前奏。 在可辨識首次原始碼編輯的 284 條執行軌跡中,代理程式平均到第 8.47 輪才開始編輯。即使啟用平行工具呼叫,軌跡中位數仍需要 6 輪循序探索,以及 15.5 次探索工具呼叫,才進行第一次編輯。
- 問題越難,探索越多。 未解決的執行軌跡平均有 8.34 輪編輯前探索,已解決的則為 6.67 輪。主張並非探索導致失敗,而是探索 (a) 成本高到足以造成影響,且 (b) 結構明確,適合委派。
由此可見兩種不同的傷害:token/上下文成本(求解代理程式必須支付每個探索片段的成本,並一路攜帶它們——見 Context Window Smart Zone),以及雜訊(探索漏掉關鍵檔案或累積無關上下文時,求解代理程式會在受污染的視窗中推理,之後可能得花時間修正錯誤假設,而不是解決真正原因)。
這也是 SWE-Pruner(Wang 等人,2026 年,針對程式碼代理程式進行上下文剪枝)所要解決的相同瓶頸——兩者的差異很有啟發性。剪枝是在事後移除受污染的上下文;探索子代理程式則把搜尋留在獨立對話中,從一開始就不讓它污染上下文。兩種策略,解決同一個問題。
2026-08-03 由 Tool-Output Pruning 更新: SWE-Pruner 的後繼方法在代理程式—環境邊界進行剪枝——工具回應會在輪次之間被替換,因此只存活一代,永不累積。「事後」準確描述了 2026 年的前代方法,對當前最先進做法而言則說得太重;如今兩種策略的差異是暴露一輪,而非上下文累積。這讓兩者如何組合成為更值得追問的問題,而非已有定論——見下方的開放問題。
委派契約#
FastContext 是一種執行階段的委派機制,不是新的模型架構。主代理程式交給它一個自然語言查詢(「找出 Goldmark 圖片 render hook 的程式碼路徑……」),收到的是證據,而非修補程式。三項刻意的設計選擇定義了這項契約:
- 三種語言無關的唯讀工具,僅此而已:
READ(含行號的檔案內容)、GLOB(路徑探索)、GREP(正規表示式搜尋,ripgrep)。探索代理程式無法編輯檔案或提交修補程式——它在結構上就不具備解題能力,只能定位。 - 每輪平行執行。 每一輪中,探索代理程式要麼呼叫一個或多個工具(並行執行,以涵蓋互補假設後再綜合),要麼停止並給出最終答案。
- 精簡的輸出契約。 回傳內容是由
path:line-range項目構成的<final_answer>區塊,可附上簡短的相關性說明,例如:
<final_answer>
/src/router.py:42-58 (Router definition)
/tests/test_router.py:101-119
</final_answer>
只有這個區塊會重新進入主代理程式的上下文。 探索代理程式的中間工具觀察結果與推理會寫入獨立的子代理程式紀錄,不會附加到求解軌跡中——這就是保持主上下文乾淨的機制。在 Mini-SWE-Agent 中,它會以 CLI 輔助工具的形式,在同一個任務容器內執行(fastcontext -q "..." --format concise)。
這是 Claude Code、Codex、GitHub Copilot CLI 和 Cursor 中專有「subagent」功能的開放發表版本;論文指出,這些探索機制都是封閉的,因此沒有開放的訓練與評估方法可循。
訓練方法:先做 SFT,再做以任務為依據的 RL#
探索代理程式經過兩階段訓練,而非只靠提示(骨幹模型:4B 探索器使用 Qwen3-4B-Instruct,30B 探索器使用 Qwen3-Coder-30BA3B):
- SFT(策略初始化)。 從 Sonnet 4.6(Anthropic)探索軌跡取得 2,954 筆篩選後的範例,拆成三種對應執行階段行為的子來源:
parallel_toolcalls(990 筆——廣泛且不重複的第一輪搜尋)、multiturn_traj(983 筆——完整的多輪證據蒐集軌跡),以及linerange(981 筆——精確產生最終引用)。損失只套用在 assistant token 上,不計入原始工具觀察結果,但將 assistant 文字與結構化工具呼叫參數都納入目標。 - RL(以任務為依據的精煉)。 從 SFT 檢查點開始,在 395 個儲存庫中的 400 個提示上進行 GRPO。關鍵做法是:獎勵來自參考修補程式。 系統會將每個問題的標準修補程式解析為目標檔案/行號範圍(每個提示平均 11.07 個範圍),獎勵則結合 (a) 探索代理程式所引用位置與這些目標之間的檔案層級及行號層級 F1、(b) 小幅的有限平行度獎勵(若 3 < 最大平行呼叫數 ≤ 6,則為
1),以及 (c) 格式懲罰,用於拒絕空白、過長、格式錯誤或扇出過多的輸出。探索代理程式會以真正的子代理程式執行(最多 8 輪,每個提示抽樣 16 條執行軌跡)。SFT 教會它模仿探索行為;RL 則讓輸出對齊實際攸關修正的程式碼位置。
值得記住的三項發現#
- 持久的效益來自架構分離;訓練模型則是最佳化手段。 名為同模型探索的基準組,讓前沿模型本身透過子代理程式介面執行委派搜尋,不做任何專門訓練——相較於單體式解題,它已能提升分數並減少 token。因此,很大一部分效益純粹來自把探索移出求解代理程式的上下文,與小型訓練模型無關。訓練後的探索器則在此基礎上進一步改善 Pareto 表現(往往在分數和 token 兩方面都勝過同模型探索)。
- 4B-RL 探索器能勝過 30B-SFT 探索器。 在 GLM-5.1 / SWE-bench Pro 上,4B-RL 探索器得分 22.5,高於 30B-SFT 的 20.0,且 token 用量更少;在全部九種端對端設定中,4B-RL 的表現都優於或不遜於 4B-SFT。對這個狹窄角色而言,以任務為依據的 RL 勝過單純擴大規模;RL 的增益主要來自精確率相近、召回率較高——這正是修補程式涵蓋率獎勵所要最佳化的方向。(獨立定位評估:訓練後的 FastContext 達到檔案層級 F1 73.71/模組層級 F1 60.35,是最強的非前沿模型群組,在模組/函式粒度上的優勢最明顯。)
- 探索器成本低廉。 GPT-5.4 / SWE-bench Multilingual 上的 token/成本稽核顯示:直接解題每項任務花費 $282.47;主代理程式搭配 4B-RL 的成本是 $208.92 + 探索器 $4.52 = $213.44,每項任務淨省約 $69(4B 探索器採用每百萬 token $0.20 的無伺服器級計價)。效率是核心——探索必須便宜到足以成為日常輔助工具,這就是為何部署目標是 4B 模型,而非 30B 模型。
關聯文章#
- FastContext — 系統實例:訓練後的 4B–30B 探索器、模型變體、訓練堆疊與開放發布
- Tool-Output Pruning — 同一瓶頸的另一半,如今已有測量結果。FastContext 將搜尋導向別處;SWE-Pruner Pro 則在邊界壓縮觀察結果——其關鍵發現是,保留或剪除的訊號已存在於程式碼代理程式自己的隱藏狀態中(凍結骨幹模型的線性探測:AUC 0.83、最佳 F1 0.63,高於多數類別基準 0.46),因此不需要獨立評分器,也不需要目標提示查詢。推論結果在此很重要:需要外部訊號的剪枝器,取得訊號所花的 token 比壓縮節省的還多;六種先前方法中有五種會在網格中的某些設定下增加端對端 token。尚未測試它與探索子代理程式的組合,風險具體而非抽象——兩者都針對相同的探索性讀取與搜尋,因此探索器若已回傳精簡引用,逐行剪枝器能移除的內容就所剩無幾
- Context Lifecycle Management — 主代理程式 token 負擔的另一面:將雜訊隔絕在外(把搜尋委派給唯讀子代理程式),或在雜訊進入後加以管理(折疊/遮蔽/剪除索引物件,並搭配可復原的 sidecar)。兩者互補,而非彼此競爭——探索隔離無法處理已累積的軌跡,物件垃圾回收也無法預先清除求解代理程式的視窗
- Deep Modules for Agents — 探索子代理程式是個深模組:精簡介面(自然語言查詢 → 檔案與行號引用)隱藏了大量行為(多輪平行搜尋),也是 Pocock 的「在全新上下文中擔任審查者」/Sandcastle 模式用於搜尋而非審查的具體實現——求解代理程式負責委派,並維持乾淨的視窗
- Agent Harness Engineering — 將探索與解題拆開並僅回傳精簡證據,屬於 harness 設計:透過機制強制逐步揭露與隔離上下文(探索代理程式無法編輯),而非只靠指示
- Client-Side Agent Optimization — FastContext 將 AgentOpt 按角色分派模型的邏輯再往前推一步:不只把現有模型分派到探索器角色,還為它訓練專用的小型模型;探索器與求解器的分工正是按角色搭配模型的決策
- Context Window Smart Zone — 雜訊傷害是智慧區論點的延伸:探索片段會把求解代理程式推入遲鈍區;卸載搜尋能讓求解代理程式的推理視窗保持乾淨
- The Bitter Lesson — 一個仍在發展的張力:訓練專用探索器增加了人工建構的結構,表面上違背「將 harness 溶解進模型」的主張。同模型探索的結果提供了調和方式——持久效益來自架構(上下文分離),而訓練後的探索器只是效率手段,苦澀教訓預測隨著基礎模型變便宜,這種手段會逐漸縮小
- Harness Shrinkage as Models Improve — 從 harness 角度看,同樣存在這項張力:訓練後的探索元件是不可或缺的支架,還是暫時性的?論文自己的說法(「將探索呈現為明確介面,讓較小的專用模型與更強的主代理程式合作」)押注介面會持續存在,即使其中的模型有所改變
- Verification as the New Bottleneck — 定位/探索是驗證的上游相鄰工作:兩者都是主導實際代理程式執行軌跡的非解題工作;源自修補程式的 F1 獎勵,則為探索器提供可驗證的訊號
- Prompt-Cache Economics — 將精簡回傳推到極限的同一個最後一哩路問題。CAPC 的 graphify 研究測量知識圖譜索引器實際輸出的內容——節點標籤、
source_file、行號位置、社群 ID,不含原始碼——並發現對模型熟悉的程式碼庫而言,只有指標比完全沒有索引更糟(0.613,相較於沒有圖譜時的 0.647);但對模型不熟悉的程式碼庫,指標能讓分數從 0.300 提升至 0.637。解法是在每次查詢中加一層,追蹤指標並傳送約 40 行原文。對照 FastContext 的檔案與行號引用來看,共通教訓是:精簡回傳仍須承載部分內容,而適量與否取決於模型對該儲存庫的先驗知識 - Deep Research Agents — 結構相似:深度研究會將查詢拆成搜尋與綜合;FastContext 則將程式碼任務拆成探索與解題。兩者都把反覆搜尋隔離在外,只回傳精簡的綜合結果
- Task Time-Horizon Scaling — SWE-bench 系列(Multilingual、Pro、Verified、SWE-QA)是本文的評估範圍;時間跨度較長的任務(SWE-bench Pro)呈現最大幅度的準確率提升,與探索成本隨任務跨度累積的情況一致
- Claude Code — FastContext 將其專有子代理程式機制以開放方式發布
- Symphony — 另一種模組化代理程式架構(以工單驅動);兩者都將程式碼代理程式視為可組合元件,而非單體迴圈
- LLM-as-Compiler Knowledge Base — 對應的匯入時編譯方法:Cognition 的 DeepWiki 會先將五萬多個公開儲存庫編譯成各儲存庫專屬的 wiki,為 Devin 的檢索提供依據——同樣將儲存庫脈絡整理與解題拆開,但做法是每個儲存庫只編譯一次,作為共享產物,而非每項任務都開啟一次性的探索視窗
- Deterministic Engineering for Agent Code Review — 針對同一上下文污染問題,採取分散而非委派的解法。FastContext 將探索集中於一個唯讀子代理程式,回傳精簡引用;OpenCodeReview 則將任務拆分:每個變更檔案配置一個 SubAgent,各自使用範圍有限的讀取工具(
file_read、code_search、file_read_diff)和獨立視窗,需要時才擷取跨檔案依賴,而非預先收集。刻意選擇以檔案為單位,而非依 hunk 或函式拆分,理由是更細的切分會讓連貫的變更變得零碎——這是單一集中式探索器不必面對的連貫性與效率取捨。這兩種架構尚未經過相互基準測試 - LLM-Driven Vulnerability Research — 在求解者是稽核員的領域中,也有相同的拆分;而「效益來自架構還是搜尋」這個問題,只有此處設有同模型對照組。Antaeus(arXiv 2607.01138)先以關鍵字剪枝,加上一輪代理式排序,從儲存庫中只包含簽章與被呼叫函式的壓縮內容,將 186,859 個範圍內的 C/C++ 函式縮減至分析 6,112 個(30.6 倍),再將每個候選項交給分析員固定的證據包——第一層被呼叫函式主體、巨集與常數定義、typedef、匯入項目——而不讓分析員自行搜尋。三項結果值得延伸。優先排序的召回率為 100%:所有真值易受攻擊的函式都通過 30.6 倍縮減;這在一個基準上回答了「低成本篩選會不會漏掉必要項目」的疑慮。證據包並非免費,也無法互換:拿掉區域證據包會讓偵測數從 20 降到 13,拿掉儲存庫層級證據包則從 20 降到 11;因此在此處,探索器回傳哪種證據的重要性,是 FastContext 的 F1 數字所看不到的。讓模型自行探索,表現不如直接提供相同候選項:拿到 Antaeus 自己排序函式清單的 Opus 4.7 代理程式,在 35 個漏洞中找出 13 個,低於整個流程的 20 個;它只有在自行縮減搜尋範圍後,誤判數才比較少。作者明確為第一層深度辯護,認為再深入擴展呼叫圖「會分散模型注意力,卻不保證能完整涵蓋跨程序關係」——這正是前述精簡回傳的取捨,也已明確計價
衍生文章#
- Single General Agent vs. Multi-Agent Coding Architecture — 「同模型探索」的結果(持久效益來自架構分離,而非訓練模型)是關鍵證據,證明上下文隔離專門化無論模型規模為何,都勝過單體上下文代理程式
開放問題#
- 換成更好的主模型,效益還在嗎? 同模型探索的結果顯示,架構效益在某種程度上與模型無關;但隨著前沿模型變便宜、也更能獨自維持在智慧區,訓練後探索器帶來的差距可能縮小。苦澀教訓提出的問題仍未解決。
- 剪枝,還是從一開始就不讓上下文受污染。 SWE-Pruner 事後移除上下文;FastContext 避免上下文累積。兩者互補(對求解代理程式剪枝,並委派探索),還是互相替代?尚未一起測試。更新(2026-08-03): Tool-Output Pruning 將剪枝移至代理程式—環境邊界,因此兩者如今的差異是暴露一輪,而非上下文累積;而且兩者都針對相同的探索性讀取——因此預設應預期兩者有所重疊,而非效益相加。但尚未在同一基準上一併測量。
- 探索器可以縮小到多小? 作者將 1.7B / 0.6B 列為後續研究方向;若這套方法成立,探索器的成本將近乎免費,架構效益也會成為主導。
- 能否推廣至 Mini-SWE-Agent 以外? 目前只測試一種刻意精簡的主代理程式架構;功能更豐富、具備自身記憶與子代理程式協調機制的 harness,或許已取得部分效益,也可能產生不同互動。
- 源自修補程式的獎勵是否洩漏資訊。 以標準修補程式的檔案/行號範圍作為探索器的獎勵,可能導致模型過度擬合修正落在何處,而非證據所在何處;F1 與召回率的行為在一定程度上緩解此問題,但這個代理指標並不完美。
資料來源#
Cited by 17
- Agent Harness Engineering×2
At what codebase scale does the AGENTS.md-as-table-of-contents approach need to be replaced with…
- FastContext×2
FastContext is an open-source repository-exploration subagent for coding agents, from Shaoqiu…
- LLM-as-Compiler Knowledge Base×2
DeepWiki: the wiki as agent infrastructure, not documentation. "The wiki is not the product. The…
- Single General Agent vs. Multi-Agent Coding Architecture×2
Repository Exploration Subagent — "same-model exploration" (untrained) already wins: architectural…
- Tool-Output Pruning×2
Repository Exploration Subagent — the "don't pollute" counterpart, and the source that sharpens its…
- Client-Side Agent Optimization
Repository Exploration Subagent — extends model-per-role one step further: train a bespoke small…
- Context Lifecycle Management
Repository Exploration Subagent — the complementary token-reduction strategy: keep the noise out of…
- Deep Modules for Agents
Repository Exploration Subagent — FastContext applies the deep-module / fresh-context discipline to…
- Deep Research Agents
Repository Exploration Subagent — structurally parallel inside a coding agent: FastContext…
- Deterministic Engineering for Agent Code Review
Repository Exploration Subagent — the delegate-versus-distribute contrast on the same bottleneck.…
- LLM-Driven Vulnerability Research
Repository Exploration Subagent — the same decoupling, moved from coding to security: Antaeus's…
- Agent Systems & Harness Engineering
Repository Exploration Subagent — FastContext's thesis that repository exploration…
- Open Questions Dashboard
Agent Harness Engineering: At what codebase scale does the AGENTS.md-as-table-of-contents approach…
- Open Questions Backlog
Repository Exploration Subagent ×5 (oldest 105d) — Does the gain survive better main models?
- Prompt-Cache Economics
Repository Exploration Subagent — the same last-mile problem for codebase knowledge. FastContext…
- Task Time-Horizon Scaling
Repository Exploration Subagent — the SWE-bench family (Multilingual / Pro / Verified / SWE-QA) is…
- The Bitter Lesson
Repository Exploration Subagent — a live test case: FastContext trains a specialized explorer…
Related articles
- Agent Harness Engineering
Patterns for scaffolding long-running LLM agents: environment design, progressive context disclosure, mechanical archit…
- Client-Side Agent Optimization
AgentOpt's framing of developer-controlled agent optimization (model-per-role, budget, routing) as distinct from server…
- Open Questions Backlog
Generated by `_system/lint.py --write-backlog`. Do not hand-edit. Domain and Watching sections carry one row per page —…
- Agent Context Files
The cross-vendor markdown-as-control-plane pattern: repo-versioned plaintext (CLAUDE.md / AGENTS.md / SOUL.md / WORKFLO…
- Claude Code Best Practices
Anthropic's guide to effective Claude Code usage: context management, verification-driven development, explore→plan→cod…