資料來源#
- Using profiles of cognitive capability to assess AI suitability for workplace tasks
- What AI Benchmarks Actually Measure: Adapting Convergent and Discriminant Validity to Interrogate Fifty-Six AI Benchmarks
摘要#
這個 wiki 中每一種 AI 暴露度測量工具,都以工作的詞彙描述工作——O*NET 任務、詳細工作活動、職業名稱——然後詢問模型能否勝任。Prunty、Tešić、Quinn、Hernández-Orallo 與 Cheke(Leverhulme Centre for the Future of Intelligence, Cambridge;UK DSIT;Universitat Politècnica de València — [[raw/cognitive-capability-profiles-ai-task-suitability|arXiv 2608.25623]],2026-08-26,44 頁,empirical)採取了結構上不同的做法:以認知的詞彙,在一組共用向度上描述模型與工作兩者,讓兩者得以比較,而不必以其中一方的詞彙來描述另一方。
設計目標是去耦合。能力剖析與需求蒐集是在共同能力空間上分開進行的測量程序,因此可各自依不同節奏重做——模型變化很快,工作在認知上的需求變化較慢——即使模型世代更迭,框架仍可沿用,無須重新向工作者蒐集資料。作者明確指出,「因此,本研究的主要貢獻在於方法論。」
證據說明。
empirical——標註了 19,535 個基準項目、完整評估六個系統、問卷通過品質控制的受訪者共 410 人,並報告了 MCMC 收斂情形。本文保留此分級,但在將任何適配性分數視為預測之前,請先閱讀未衡量的事項:需求那一半蒐集的是重要性而非需求,且本文沒有以任何實際部署結果進行驗證。
三個階段#
1 — 認知能力剖析。 根據系統在基準測試組合上的通過/失敗紀錄,推斷其潛在能力水準;該組合的每個項目都已標註其對各向度造成的認知需求。
2 — 任務需求加權。 詢問領域專家(本文為員工),對每項工作活動而言,同一組能力各有多重要。
3 — 適配性映射。 將兩者結合:適配性是對代理程式能力水準按重要性加權後的彙總。
兩條資料流刻意採用不同性質的形式——剖析得到能力水準,需求蒐集得到重要性權重——而這種不對稱正是框架的核心限制,以下會再討論。
階段一:標註需求,而非估計需求#
能力與評分規準#
研究從心理計量學與認知科學文獻(Carroll 的因素分析綜述;Spelke 與 Kinzler 的核心知識)中選出 18 種核心認知能力,分屬四個家族,另有三種領域通用能力(表 A1,已核實):
| 家族 | 能力 |
|---|---|
| 記憶系統 | 情節記憶、語意記憶、程序記憶、前瞻記憶 |
| 執行控制 | 工作記憶、注意力與抑制控制、認知彈性、規劃 |
| 物體與空間理解 | 知覺與模式辨識、功能性知覺、空間推理與導航、物體恆常性 |
| 社會與溝通 | 心智理論、情緒知覺與同理心、語言 |
| 領域通用 | 心智模擬、後設認知、因果推理 |
每項能力都配有六點需求評分規準,從 0(不需要)到 5,每級皆有具體的錨定描述與示例任務。這些級別的動機來自對人口分布的直覺——第 1 級是多數成年人能滿足的需求,第 5 級則只有少數人能滿足——但推論只依賴級別的序位結構與幾何間距;論文並未主張這些級別對應固定的人口比例。需求級別是各能力內部定義的:第 4 級工作記憶需求與第 4 級心智理論需求,並不假定在絕對量值上等同。
這是整個流程其餘部分所依循的方法論轉折點。規準法承襲自 ADeLe 框架(Zhou 等人,General scales unlock AI evaluation with explanatory and predictive power,Nature 652,2026);該框架透過讓 LLM 評審將專家撰寫的規準套用至個別基準項目,讓既有基準能用於建構效度評估。這種做法同時取得基準的規模與心理計量設計的建構效度——也代表每個項目的難度來自規準,而非作答者群體。
基準測試組合#
22 個基準、19,576 個項目(表 1,逐格核實;項目數加總與列印總數完全相符)。目標規模約 20,000 個項目,藉由混合觀察到的需求分布(權重 0.7)與均勻分布(權重 0.3)建構——前者讓涵蓋範圍能代表常見需求,後者確保少見的高需求項目仍會保留——並限制任何單一資料集不得占整個組合超過 10%。占比最高的來源為 Fantom(2,177)、OpenToM(2,000)、PlanBench(2,000)、AGIEval(1,896)、StepGame(1,563)、Text Navigation(1,413)、MetaMedQA(1,373)、BigBenchHard(1,265)、EmoBench(1,200);MMLU-Pro 提供 200 個項目。
兩位標註者,以及篩選排除了什麼#
每個項目都由 GPT-4o 與 Gemini 3 Flash 各自獨立依照評分規準標註。評分者間信度(表 A2,已核實)直接淘汰了兩個向度:
- 注意力與抑制控制:ρ = 0.09,κ_w = 0.07
- 前瞻記憶:ρ = −0.03,κ_w = 0.15
保留的 16 個向度,ρ 從 0.38(心智模擬)到 0.81(心智理論),與排除的兩項明顯區隔;即使一致度最低的向度,在 ≥ 74% 的項目上,兩位標註者的評分也相差不到一個需求級別。評分取平均;任一評分者給出無效評分的 41 個項目被剔除,最後留下 19,535 個。
十八種能力中,有兩種無法由兩個前沿模型閱讀同一份規準後可靠標註,這本身就是一項發現;而被排除的兩項都屬於執行/時間性構念——持續注意力與記得稍後要做某事——正是標註者最難從項目的靜態文字中掌握的能力。
八個向度,因為需求彼此重疊#
認知需求高的項目會同時動用多種能力,因此各需求欄位高度正相關,推論模型也就難以區分相應的潛在能力。對經 z 分數標準化的需求剖面相關矩陣進行階層式凝聚分群,並以距離 1 − r = 0.5 切割後,得到八個綜合向度(表 A3):
| 向度 | 組成能力 |
|---|---|
| 情節記憶(EM) | — |
| 語意記憶(SM) | — |
| 物體恆常性(OP) | — |
| 語言(L) | — |
| 社會認知(SC) | 情緒知覺與同理心、心智理論 |
| 工具性推理(IR) | 因果推理、功能性知覺 |
| 資訊整合與控制(IIC) | 工作記憶、認知彈性、後設認知、知覺與模式辨識 |
| 行動規劃與模擬(APS) | 規劃、程序記憶、心智模擬、空間推理與導航 |
論文謹慎指出,這些群集反映的是各項目需求的共同出現情形,而非概念相似性——概念上不同的能力可能只是總是一起被需要。這與 Benchmark Score Redundancy 在分數層級遇到的可識別性問題相同,只是這裡發生在項目標註層級;解法也一樣:合併共線欄位,而不是假裝它們可以分開。
結果中的需求分布有兩個特性會影響後續分析(表 2,已核實):沒有任何項目在任何向度上達到第 5 級,而各向度涵蓋率差異極大——IIC 與 L 出現在 100% 的項目中,SM 為 99%、APS 為 94%、IR 為 92%,但 EM 為 50%、SC 為 42%、OP 為 36%。所有項目都需要語言,但其中 97% 的需求只在第 1–2 級。涵蓋率高、範圍卻窄,是可識別性風險;恢復分析正是為了檢驗這個問題而設計。
推論:IRT 的難度值已給定,而非擬合得出#
剖面使用 Measurement Layouts(Burden、Voudouris、Burnell、Rutar、Cheke 與 Hernández-Orallo,2023)估計,這是一種貝葉斯項目反應模型。每個項目帶有需求向量 D_j ∈ {0..5}^K;每個代理程式帶有對數能力向量 c_k = log θ_k。難度為 δ_jk = e^(λ D_jk),其中 λ 固定為 1;代理程式在向度 k 上的差距是對數比值 m_jk = c_k − λD_jk。不活躍向度(D_jk = 0)恰好貢獻零,因而會被排除。各差距彙整為項目 logit,再透過 sigmoid 對應至 Bernoulli 結果。
彙整規則是實質的建模選擇,其參數位於一條連續軸上,兩端分別是補償式(某一能力的強項可彌補另一項能力的不足)與瓶頸式(無論其他能力多強,表現都受限於需求能力中最弱的一項)。溫度 τ 的 soft-minimum,在 τ → 0 時可還原平均彙整,在 τ → ∞ 時則可還原短板效應。
這是與 Item Response Theory for LLM Benchmarks 最鮮明的差異。 ATLAS 根據約 4,000 個 Open LLM Leaderboard 模型的作答模式校準 3PL 項目難度 b,因此 b 是那個受試者群體的特性——「對 2023–2024 年開放權重微調模型生態系而言很難」——而且該量尺容易受到時間漂移影響(在單一一年校準邊界後,能力 MAE 約惡化 50%)。此處的難度完全不依賴作答矩陣,而是由非受試者身分的標註者依規準判定。相對於模型群體,題庫不會過時,因為它從未錨定在某個模型群體上。代價則出現在別處,而論文坦率說明了代價所在。
恢復分析實際證明了什麼#
從先驗分布抽出 20 個合成代理程式,在真實基準測試組合上模擬作答,再重新擬合剖面。有兩項選擇由此確立(表 4 與表 5,皆已逐格核實):
彙整溫度。 在補償式基準(τ = 0)下,涵蓋率最高的三個向度恢復效果最差——IIC 0.61、L 0.67、SM 0.73——正好印證涵蓋分布所預示的可識別性疑慮:每個項目都會啟用的向度,很少能由資料單獨辨識。提高 τ 可改善恢復效果(τ = 1 時分別為 0.83 / 0.90 / 0.92),代價是工具性推理從 0.89 降至 0.76。研究採用 τ = 1,因為它讓最差向度的恢復效果最高,而非讓平均值最高。
截距。 由於彙整只取決於差距 c_k − λD_jk,將每項能力都提高同一數值、並以相同數值降低截距,在觀察上無法區別。因此,允許每個代理程式各有自由截距會讓整體水準無法識別(水準恢復 r = 0.12),但形狀仍能維持(r = 0.92);改用整份目錄共用的單一截距,則讓水準恢復提升至 0.98、有效後驗向度數從 2.7 提升至 6.7,後續適配性恢復率也從 ρ = 0.14 提升至 0.91——幾乎等同於使用模擬真實值固定 α 的預言機。
因此,本頁所有水準數字都有適用範圍限制。 能力水準只能相對於目錄中的其他代理程式識別;新增或移除系統會改變共同參照點,而且不同目錄各自擬合出的絕對水準不可互相比較。無論如何,剖面形狀仍可識別。這與 Item Response Theory for LLM Benchmarks 對群體相對難度的提醒形式相同,只是換了位置:那裡是項目錨定於模型群體,這裡則是代理程式錨定於模型群體。
而且,恢復分析實際證明的內容比表面上少,作者也直言不諱:模擬資料與擬合資料使用相同的建模參數,因此「這項分析證明了內部可恢復性,卻不能證明這些建模假設在經驗上有效。」真實任務表現是否真的會以 τ = 1 的 soft-min 方式彙整,尚未經過檢驗。
階段二:410 位工作者分配 100 點#
研究從 O*NET 工作活動類別改編出 18 項工作活動(表 B1,已核實),並挑選六個職務領域,代表一家產品公司的各部門,讓活動能跨領域比較:倉儲或物流(WL)、製造/維護/修理(MMR)、數值/資料/程式設計(NDP)、行政/組織/規劃(AOP)、客戶服務/行銷/人資(CMH)、餐旅/銷售/客戶照護(HSC)。
樣本。 透過合作企業招募 125 位受訪者,另經由 Prolific 招募 414 位;總計 539 人,品質控制後 410 人(完成問卷、能力測驗答對率 ≥ 50%、作答至少 ≥ 10 分鐘——分別剔除 59、66 與 4 人)。表 B2 已核實,兩個方向的邊際總數都完全相符(85 + 325 = 410;125 + 414 = 539)。平均年齡 40.3 歲,49.8% 為女性,多數具有學位;目前職務年資 5.7 年,整體職涯年資 11.8 年;對 AI 的態度略偏正面(平均約 58/100)。原始資料未提供招募平台以外的國籍資訊;企業名稱也未公開。
研究工具。 四個階段,約 30 分鐘:人口統計資料 → 選出最重要的五項活動、排序並回報每週投入時數 → 熟悉能力項目(涵蓋全部 18 種,每種附定義、跨領域示例與說明圖片),再完成一份配對測驗,同時作為注意力檢核 → 對每項選取的活動,挑出最不可或缺的五種能力,並將 100 點分配給這些能力,情境設定為替「機器人助手」配備能力。
彙總時採用頻率調整:未選取的項目得分為零而非缺漏,因此能力權重同時反映活動被選取的頻率,以及被選取時分配給它的比重。
樣本驗證。 各領域的招募來源分布相當不均——體力型領域幾乎完全來自線上樣本(品質控制後的 WL 有 36 人、MMR 有 33 人)——所以研究先比較企業與線上樣本的重要性矩陣,再進行合併。依活動計算的一致性為 cosine 0.91 / Pearson 0.80;依能力計算則為 0.85 / 0.52,較低的數值來自很少被選取、只能根據少量觀察估計的能力。折半信度上限顯示來源內信度最高可達 0.94,且來源間去衰減後的 r 約為 1——兩個樣本的一致程度,幾乎等同同一樣本中隨機抽出的兩半。這是真正的信度結果,但必須精確說明其意義:它只顯示研究工具在不同招募管道間具備內部一致性,並不代表它所蒐集的內容有效描述了認知需求。
工作者認為哪些事重要#
活動(依頻率調整的重要性 I_t,跨領域平均):解決問題 2.04、決策 1.78、檢查 1.44、研究 1.35、使用電腦 0.96 居前;聆聽 0.29、寫程式 0.38、管理資源 0.39、資料操作 0.39 居末。由於權重將感知重要性乘以選取頻率,廣泛適用的活動會排在只對少數人極為重要的活動之前——寫程式的 0.38 是基準率造成的結果,不代表研究主張寫程式在相關工作中不重要。
解決問題與決策在每個領域都名列前茅或接近前茅;領域之間則由輔助活動區隔。WL 與 MMR 的檢查分別為 2.43 和 2.45,高於整體的 1.44;工具使用分別為 1.32 和 1.88,高於 0.67。NDP 的使用電腦與分析資料均升至 1.89,寫程式為 0.68、資料操作為 1.06。AOP 唯一提高了長期規劃的權重(0.94,相較於 0.47)。HSC 的建立融洽關係最高,為 1.83。
重要性不等於時間。 檢查的重要性名列前茅,每週卻只占 10.2 小時;使用電腦每週耗時最多,為 15.7 小時,但重要性僅屬中等;工具使用 14.7 小時、管理人員 13.4 小時、行政工作 10.8 小時,也都呈現投入時數高於重要性排名的情形。因此會產生兩種不同部署情境——增強高價值工作,或減輕高工時工作——論文同時納入兩者(圖 C6 與 C7)。
能力。 任務 × 能力矩陣由一組共同認知核心主導:規劃、語意記憶、工作記憶、語言與程序記憶,在幾乎所有活動上都占最大權重。活動之間的差異出現在次要能力——人際工作涉及社會認知、分析工作涉及模式辨識、創意工作涉及心智模擬。各領域的矩陣逐格相關為 r = 0.53–0.77(平均 0.63),差異最大者為 WL 在空間推理與導航上 +2.1、MMR 在規劃上 +2.5,以及 HSC 在心智理論上 +1.7、情緒知覺與同理心上 +1.2——全是次要能力,核心項目則毫無差異。
這個 wiki 從另一個角度一路探討這種收斂。Task Crossover 發現,職業特定 AI 使用中有 43.5% 是其他職業的工作;Task Saturation: Broad but Shallow AI Diffusion 則發現,AI 涵蓋到的職業,其任務中位數有 21% 會用到 AI。穩定的跨職業認知核心可能是兩者背後的機制:若職業主要在次要能力上有所不同,跨越職業界線的便會是那些依賴共同核心的任務。
六個系統的樣貌#
兩個開發者家族的六個系統——Gemini 2.5 Flash、Gemini 3 Flash、Gemini 3.1 Pro、GPT-4o-mini、GPT-5-nano、o4-mini——以共用截距共同擬合,每條鏈 2,000 次抽樣、共 4 條鏈,R̂max ≤ 1.013,且 bulk ESSmin ≳ 350(表 C5,已核實)。
| 系統 | 基準正確率 | 整體水準 c̄ |
|---|---|---|
| Gemini 3.1 Pro | 73.3% | 3.70 |
| Gemini 3 Flash | 68.4% | 3.38 |
| o4-mini | 61.8% | 2.88 |
| GPT-4o-mini | 48.7% | 2.79 |
| GPT-5-nano | 56.0% | 2.75 |
| Gemini 2.5 Flash | 44.8% | 2.58 |
請注意,正確率與推斷出的水準已出現分歧:GPT-4o-mini 的原始正確率最低(48.7%),能力水準卻排第四(2.79),高於答對項目多出 7.3 個百分點的 GPT-5-nano。這正是 Item Response Theory for LLM Benchmarks 所記錄的 IRT 重排序效應;此處以規準衍生、而非群體衍生的難度重現了相同現象——各向度表格也揭示其機制:GPT-4o-mini 答對的項目集中在高需求的語言與社會認知題目。
各向度概況(表 C6,逐格核實)#
| 系統 | IIC | L | SM | APS | IR | EM | SC | OP |
|---|---|---|---|---|---|---|---|---|
| Gemini 3.1 Pro | 4.90 | 5.03 | 6.25 | 4.25 | 1.44 | 2.67 | 4.79 | 0.27 |
| Gemini 3 Flash | 5.06 | 4.96 | 6.12 | 2.37 | 1.32 | 2.93 | 4.18 | 0.11 |
| o4-mini | 2.92 | 2.90 | 6.34 | 1.63 | 1.71 | 3.23 | 4.42 | −0.10 |
| GPT-4o-mini | 2.21 | 4.93 | 5.73 | 0.03 | 2.05 | 2.98 | 4.18 | 0.19 |
| GPT-5-nano | 4.19 | 2.22 | 6.17 | 1.34 | 1.30 | 4.51 | 2.59 | −0.34 |
| Gemini 2.5 Flash | 2.91 | 4.07 | 2.95 | 2.31 | −0.51 | 3.06 | 4.32 | 1.58 |
| 平均 | 3.70 | 4.02 | 5.59 | 1.99 | 1.22 | 3.23 | 4.08 | 0.29 |
(此處省略後驗標準差,範圍為 0.12–0.52;平均列與表 6 完全相同,是跨越論文不同頁面兩份表格的獨立一致性檢查。)
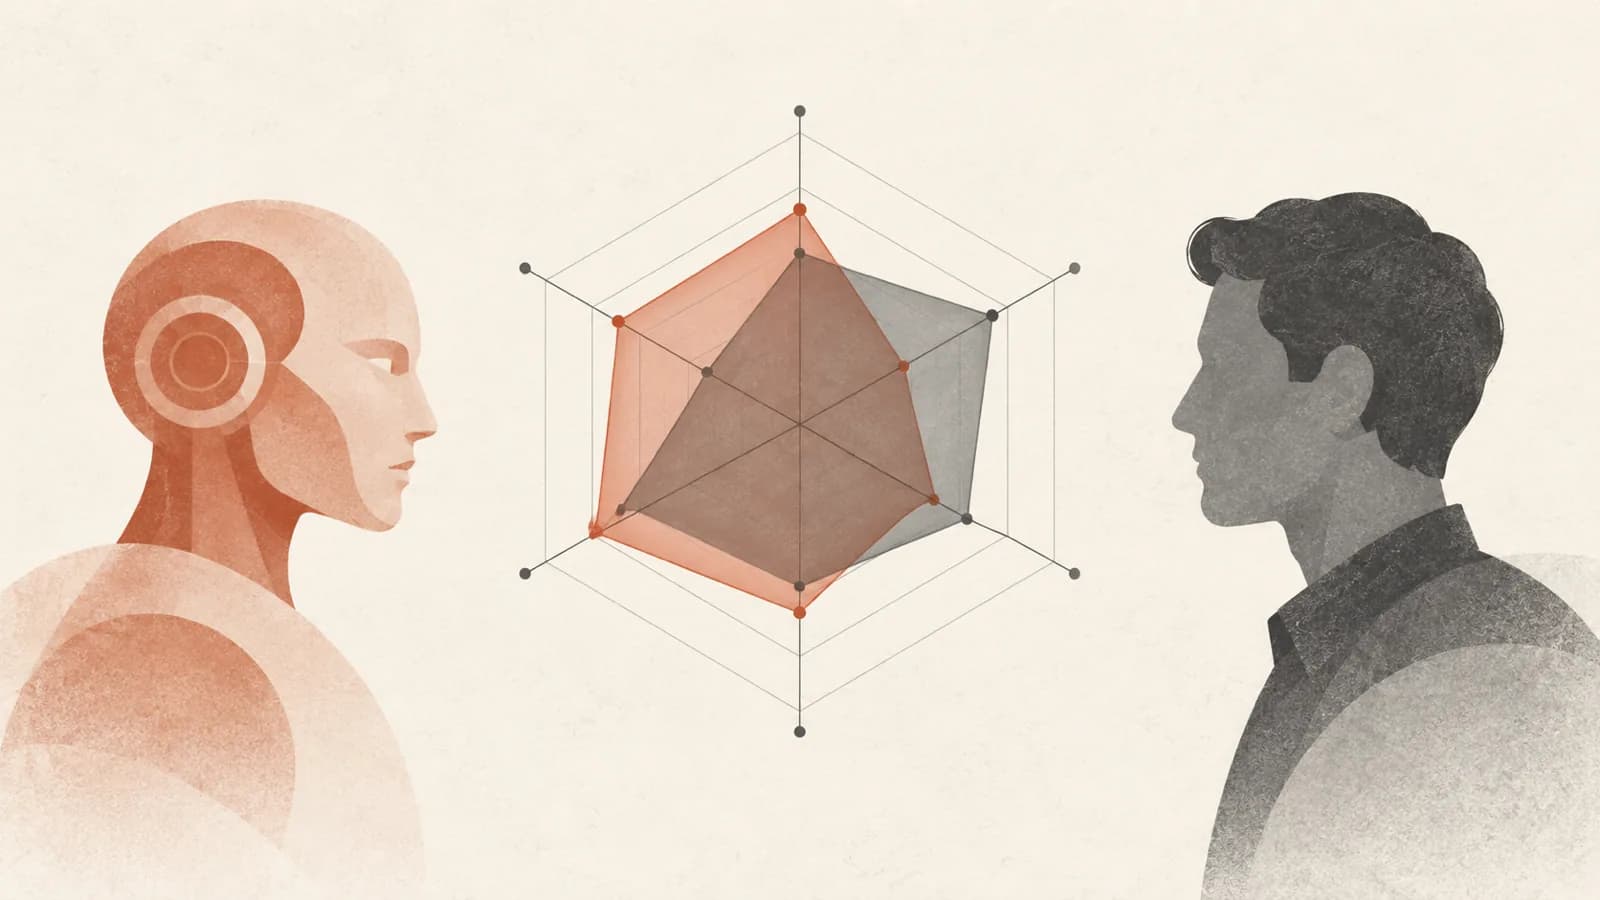
各系統的向度排序幾乎一致。 六個系統中有五個以語意記憶為最強向度(c ≈ 5.7–6.3);例外是 Gemini 2.5 Flash,其社會認知最高。行動規劃與模擬、工具性推理、物體恆常性始終是表現最低的三項。現有系統擅長知識、語言與社會理解,較不擅長規劃,以及對行動和物體進行推理。
領先者的差異不在知識。 Gemini 3 系列模型的最大優勢在於資訊整合與控制(5.06 和 4.90,而其他系統約為 2–4),以及行動規劃與模擬;Gemini 3.1 Pro 的 4.25 比次高系統的 2.37 高出 1.88,是整張表中最大的差距。知識與語言相關能力的差異相對較小。作者的解讀是,近期代理程式行為的進展來自更高層次的協調,而非對物體及其互動進行穩健推理——兩個領先系統的物體恆常性仍只有 0.27 和 0.11,工具性推理則為 1.44 和 1.32。
參差不齊的剖面各有資訊。 Gemini 2.5 Flash 是唯一物體恆常性高於 1 的系統(1.58),也是唯一工具性推理為負值的系統(−0.51);其語意記憶(2.95)則比其他所有系統低 2.8–3.4。GPT-5-nano 的情節記憶特別突出(4.51),同時卻是語言(2.22)與社會認知(2.59)最低的系統。GPT-4o-mini 的工具性推理最高(2.05),行動規劃水準卻只有 0.03——幾乎等於沒有。這些系統並非沿著單一軸線排序,而是各有不同形狀;這正是論文的主張。
標題主張,以及它的確切依據#
「AI 系統在認知向度間的差異,大於模型家族間的差異。」在數值上,這個主張依據的是兩種跨度的比較:
- 各向度間(表 6 平均值):0.29(OP)至 5.59(SM)——範圍為 5.30。
- 各系統間(表 C5 整體水準):2.58 至 3.70——範圍為 1.12。
約為 4.7 倍。論文中完全沒有報告變異數分解、ANOVA 或正式效應量比較——作者是指著一張表與一張雷達圖(圖 3)提出主張,因此應將它視為描述性觀察來引用。這種比較也部分源於建構方式:向度跨度所用的量尺,明確表示不同向度的錨定值並非絕對值(第 4 級工作記憶需求與第 4 級心智理論需求不等同),因此比較 0.29 與 5.59,就是比較論文其他地方拒絕視為等同的數字。系統水準的比較依據較扎實,而它的數值也較小。
per-system 表格所支持、較站得住腳的發現是關於形狀:來自兩個實驗室、橫跨三代的六個系統,呈現的剖面向度排序幾乎完全一致;家族成員身分對剖面形狀的預測力很差(在八個向度中,有五個向度上 Gemini 2.5 Flash 與 Gemini 3 Flash 的相似度不如 o4-mini)。
論文未提及的世代限制#
這份目錄不是前沿模型目錄:六個系統中有五個明確屬於平價級距(兩個 Flash 模型、兩個 mini、一個 nano),Gemini 3.1 Pro 是唯一全尺寸系統;清單中沒有 Claude、Grok 或任何開放權重模型。由於目錄內共用截距,本頁的每個水準都錨定於一個以小型模型為主的參照點,而論文自己的適用範圍規則也禁止把這些水準沿用至組成不同的目錄。因此,摘要所稱的「六個 AI 系統」,其實是六個具特定且不具代表性特質的系統。
階段三:適配性,以及它變動幅度之小#
適配性 S_at 是以 p 次方定義、基於比率尺度能力的加權冪平均;其中 p = 0(加權幾何平均,是比率尺度量值自然的中點),銳化指數 s = 1 為中性預設值。兩者都是決策階段的政策參數,而非從資料推斷而得:p 控制能力間的可替代性(p → −∞ 表示短板效應,p > 1 則允許單一突出強項主導結果),s 控制權重的集中程度。各能力的後驗分布獨立傳遞,權重不確定性則透過從以蒐集到的剖面為中心之 Dirichlet 分布抽樣納入,因此適配性本身也是一個後驗分布。
在 18 項活動中:Gemini 3.1 Pro 對每一項都是最適合的系統(log S 約為 4.1–4.6),Gemini 3 Flash 始終第二(約 3.3–4.1),其餘四個系統則形成彼此高度重疊的較低群組(約 1.7–3.4)。不同活動幾乎不會改變排名——「系統彼此之間的差異,遠大於活動區分系統的程度。」
這種穩定性直接來自共同認知核心。幾乎所有活動都會依賴知識、語言、規劃與認知控制;系統在前兩項差異很小,在後兩項差異較大,因此幾乎任何加權方式都會得出相同排序。例外是偏社交的活動——建立融洽關係、聆聽、溝通——這些活動對社會認知與語言的需求高到足以部分打破原有排序,使 GPT-4o mini 躍升至中段系統之首(log S 約為 3.4)。
不確定性如預期會隨樣本數改變:寫程式的重要性剖面僅根據約 20 位受訪者,圖上的區間最寬;解決問題的樣本充足,區間則最窄。
部署優先順序。 適配性表示系統能否執行某項任務,不代表執行該任務是否重要。乘上任務重要性(P_at = I_t · S_at)後,排名會轉向以研究、行政工作與分析資料為整體優先度最高的目標。單一企業案例研究(Company X,品質控制後 35 份回答,以 AOP 與 CMH 為主)顯示,溝通與研究是最明確的機會,解決問題與使用電腦則是高重要性能力缺口。
敏感度。 大幅調整 p 與 s 後,平均而言,15 組系統兩兩排序中近 12 組仍然成立;在整個補償性設定範圍內,每項任務僅出現三至七種不同排序;Gemini 3.1 Pro 在 18 項活動中的 17 項仍居首(只有行政工作在最極端的補償式設定 p = 2 時翻轉)。發生重排序時,變動也僅限於剖面本就重疊的相鄰系統。
未衡量的事項#
引用任何適配性數字之前,務必先讀這一節。
衡量的是重要性而非需求——因此沒有任何校準。 作者明確表示,整個流程「衡量的是任務重要性,而非任務需求」,因此適配性分數「指出哪些代理程式與某項任務較為匹配,卻不代表代理程式成功執行任務的機率」。能力那一半採用以需求為錨定的量尺;需求那一半則是相對重要性預算。作者提出的解方——將以規準為基礎的需求標註延伸至實際職場任務——被判定不適合組織規模的應用,因而沒有實施。
沒有任何結果以觀察到的成果驗證。 研究做了兩項驗證:(a) 合成代理程式恢復分析;作者表示,由於模擬與擬合使用的是同一個模型,這只能證明內部可恢復性;(b) 企業與線上問卷的一致性檢查,檢驗的是研究工具信度。論文完全沒有任何部署結果、生產力衡量或實際採用序列,也沒有報告與 GDPval Benchmark、Anthropic Economic Index、ATLAS 或任何其他外部暴露度測量工具的相關性。這套框架最主要的賣點——預測系統在哪些工作上行得通、哪些行不通——尚未經過檢驗。
基準測試組合恰好低度取樣系統表現最弱的面向。 由文字型評估為主的項目組成,因此多模態知覺、長期規劃與互動式工具使用代表性不足。作者承認:「因此,系統在這些向度上的真實差異可能大於目前剖面所顯示的程度」——也就是說,物體恆常性、工具性推理與行動規劃的低分,同時是模型特性與文字型基準的共同結果,不能只歸因於模型。表 2 所示的沒有任何項目在任何向度上達到第 5 級需求,具體說明了這一點:基準中最難的項目,仍未達到它自身量尺的最高級別。
這些是基礎模型,而非部署系統。 支架正是用來彌補此處測得弱點的手段:「能有效追蹤背景狀態的監控器,確實能提供物體恆常性;而明確定義的工具,則透過列出可用動作,降低對可供性知覺的需求。」裸模型的能力剖面,不等於任何人實際部署的代理程式剖面——這正是 Harness Shrinkage as Models Improve 從 harness 面向探討的落差。
源自人類的需求可能錯誤描述 AI 使用的能力。 論文舉例:人類程式設計師依賴規劃與程序記憶,當代系統卻往往仰賴統計模式比對而成功;因此,從人類蒐集的需求剖面,可能會錯誤加重對非人類代理程式所需能力的權重。作者表示,這「無法在框架本身內部解決」,必須透過部署成果驗證——而這正是論文欠缺的部分。
自我覺察能力限制了需求端。 後設認知、空間推理與物體恆常性很少被選取;作者將此歸因於它們不易透過有意識反思察覺,而非貢獻較低,五項能力的活動上限也加劇了此現象。自動化認知歷程正是自我報告無法捕捉的部分——弔詭的是,物體恆常性同時是所有受剖析系統得分最低的向度,也是工作者幾乎不會提名的能力,因此流程兩端都在同一處視而不見。
論文討論了一種循環性,卻未討論另一種。 對於 LLM 標註 LLM 所接受評估之項目需求的一般疑慮,論文藉由區分角色來處理(標註者是套用規準的分類器,不是受試者),並指出規準編碼了人類專家的判斷。但論文未提到本實驗中具體的重疊:Gemini 3 Flash 同時是兩位需求標註者之一,也是六個受剖析系統之一。它自己的一部分基準難度,是由它自己標註的。與 GPT-4o 取平均會稀釋這個問題,而且需求量尺在任何系統執行測試前就已定義,因此未必足以致命——但論文並未處理此事;下一版完全可以輕易檢查標註者與受試系統是否分離。
在各種暴露度測量工具中的位置#
若將其視為勞動力測量工具,而非評估方法,這就是 Exposure Taxonomy: Observed, Theoretical, Reported, Anticipated 所列七種工具之外的第八種工具,也是第一種既不以任務描述、也不以使用紀錄為基本單位的工具。該頁列出的每種工具都會為工作評分——Eloundou 的 GPT-4 任務評分、Felten 的 52 種 O*NET 能力、Webb 的專利動詞-受詞配對、Frey 的全職務自動化機率,以及根據 Anthropic/OpenAI 使用資料推導的工具——再詢問 AI 涵蓋了其中多少工作。本文的方法為模型的認知構念評分、為工作的同一組構念評分,再以匹配度推導暴露度。
Felten 以能力為基礎的工具與本文最接近,兩者的對照也很有啟發性:Felten 透過 2,000 位 MTurk 工作者,依「AI 適用性」評定 O*NET 的 52 種人類能力,測量的是群眾對技術的預測。本文則根據 19,535 個實測項目結果,評估具名系統的能力,並非任何事物的預測。Steele 與 Cruz 發現,暴露度測量工具是否相關,取決於它們是否共用資料來源,而非宣稱測量相同構念;這讓本文工具的定位成為真正開放的經驗問題——它的資料來源(基準作答矩陣)與清單上的其他工具都不同;依該頁的概括推論,它應該不會與任何一種工具相關。
目前沒有人做過這項比較。這很容易執行——剖面與重要性矩陣已公開(github.com/Kinds-of-Intelligence-CFI/Task-Suitability-Profiles),而且 18 項活動都有 O*NET 對照表——也是任何人能利用這篇論文進行的最有資訊價值之事。
相關連結#
- Item Response Theory for LLM Benchmarks — 同一個測量家族,難度參數來源方向相反。ATLAS 根據約 4,000 個模型的作答估計項目難度,使
b相對於受試者群體,並受時間漂移影響;本文則透過 LLM 評審套用專家規準,對需求進行標註,因此題庫不會相對於模型群體過時。兩者最後都得到錨定於偶然條件的量尺——前者錨定於受試者群體,本文則透過共用截距錨定於擬合目錄——坦白說,兩者都沒有產生絕對能力量尺,只有兩種不同的相對量尺。兩者也都重現了正確率重排序效應:GPT-4o-mini 在原始基準正確率上墊底,推斷出的能力卻排第四 - Exposure Taxonomy: Observed, Theoretical, Reported, Anticipated — 第八種工具,採用七種既有工具都未使用的構念軸,也是第一種以實測能力而非評分任務為基本單位的工具。依據該頁概括的資料來源推論,它與另外七種工具的預測相關性接近零——尚未檢驗
- Benchmark Score Redundancy — 共線性問題往下一層出現。該頁的矩陣是模型 × 基準分數,有效秩為 2;本文的共線性則出現在 19,535 個項目的需求欄位間,透過以 1 − r = 0.5 為切割點進行分群,迫使 16 項能力合併為 8 個綜合向度。解方相同、粒度不同——也為 CollabEval 發現項目層級矩陣需要約 16 個成分提供第三個資料點:即使作答模式沒有共線性,項目上標註的需求仍然共線
- Economic Benchmark Construct Validity — 把向度對調後,仍是單一能力或多種能力的問題。Zhu 對模型 × 基準進行因素分析,發現一個因子占共同變異的 74.5%,且與發佈日期的 R² = 0.505 相關;本文則依認知理論預先指定因子,再依它們評估項目,因此向度數是設計選擇,而非研究發現。Zhu 的日曆混淆正是本文設計要避免的問題——規準化需求級別不會隨發佈日期變動——但共用截距又重新引入了類似問題,因為目錄成員一改變,參照點就會移動
- GDPval Benchmark — 以結果衡量的對照案例,也是本文未曾進行的比較。GDPval 詢問模型的交付成果是否勝過一位有 14 年資歷專業人士的實際工作產出,並以盲測兩兩勝率評分;本文則詢問模型的認知剖面是否符合工作者所述的活動需求。前者將產出與現任專業人士比較,卻沒有能力分解;後者分解能力,卻從未觀察產出。讓六個受剖析系統接受 GDPval 公開黃金子集的測試,再與適配性做相關分析,是一項明顯卻尚未完成的驗證
- Measuring Beyond Accuracy Saturation — 對「彙總分數所能告訴你的有限」這個問題的第三種回答。該頁為飽和的基準新增軸向(可靠度、成本、支架貢獻、人類提升);Item Response Theory for LLM Benchmarks 改變量尺;本文改變測量單位——依據項目實際動用的認知構念,而非名義上所屬的任務領域,重新整理既有基準;這不需要新的測量工具或項目,只需為既有題庫進行規準標註
- Task Crossover — 穩定的跨職業認知核心,是任務跨職業流動的一個候選機制。若六個職業領域的能力矩陣相關為 r = 0.53–0.77,差異只在次要能力,那麼依賴共同核心的任務,正是理應跨越職業界線的任務——從認知角度看,這正符合 43.5% 的職業特定使用情況屬於其他職業的工作。兩者也共用依據:工作活動詞彙都取自 O*NET,因此都承襲該分類法可能有的缺陷
- Task Saturation: Broad but Shallow AI Diffusion — 關於深度的對照。ATLAS 發現,AI 涵蓋到的職業,其任務中位數有 21% 會用到 AI;共同認知核心,加上系統在知識/語言上強、規劃/物體上弱的剖面,恰好預測了這種模式——透過核心廣泛觸及,次要需求落在 APS、IR 或 OP 的活動則僅淺層滲透
- Machine Self-Report Psychometrics — 從相反方向探討模型心理計量。該頁發現,人類問卷用於模型時會失效,因此需要專門設計的工具;本文則完全拒絕使用人類工具,改從項目需求建構能力空間。兩者都得出相同診斷——擬人化移植是失敗模式——但選擇了不同的逃脫方法:重建研究工具,或重建既有工具評分所用的量尺
- Harness Shrinkage as Models Improve — 說明為何基礎模型的能力剖面不等於部署代理程式的剖面。論文舉例,狀態監控器能提供物體恆常性,明確的工具設計能降低可供性知覺需求;而這些系統得分最低的每個向度,都是 harness 預計要補足的能力
- Returns to Expertise in Agentic Coding — 從相反方向指出需求端的盲點。問卷蒐集的是任何代理程式從事某項活動時所需的能力,刻意聚焦於工作中不會區分不同工作者的部分;領域專業知識這種最能放大代理程式效能的要素,則依設計排除在能力集合之外
- Benchmark Convergent and Discriminant Validity — 本頁在項目需求中發現的共線性,再次出現在基準結果與標籤層級。Desai 等人發現,推理、知識與理解基準對 53 個模型的排序,在不同標籤間的相似程度與相同標籤內一樣高(組內 − 組間 ρ = −0.00);就如本頁標註的 16 項能力,因高難度項目會同時動用多種能力而合併為八個綜合向度。兩項結果都沒有說這些能力其實是一回事,只是說測量工具無法將它們區分。該研究的安全性網格則提供反例:同標籤安全基準幾乎不收斂,因此「多種向度」在那裡是更準確的描述
待解決的問題#
- 能力剖面適配性是否與任何實際結果相關?本文沒有以部署、生產力指標或現有暴露度工具評分。這項問題可直接證偽,成本也低,因為剖面與重要性矩陣都已公開:針對相符職業,將六個系統逐活動的適配性與 GDPval 勝率相關;再將 18 項活動的適配性與既有的任務層級觀察暴露度指標相關。若與依任務評分的工具幾乎零相關,便能證實 Steele 與 Cruz 的資料來源概括;若相關性強,則會讓本文成為第一個連結不同家族的工具。
- 物體恆常性、工具性推理與行動規劃低分,究竟是模型特性,還是文字型基準造成的結果?論文表示基準對這些能力的取樣恰好不足,真實差異「可能更大」;表 2 又顯示沒有項目在任何向度上達到第 5 級需求——因此,低分是根據基準本身設定的上限量得。可證偽的做法是依照相同規準,以多模態與代理程式基準重跑流程,再檢查最低的三個向度能否更清楚地區分系統、差異是否縮小,或排序是否改變。
- 同時也是受試者的標註者,會不會造成自身剖面偏誤?Gemini 3 Flash 標註了 Gemini 3 Flash 隨後接受剖析的基準需求級別,但論文對循環性的討論沒有處理這個特定重疊。可利用公開標註結果證偽:只使用 GPT-4o 的需求矩陣、再只使用 Gemini 3 Flash 的需求矩陣,分別重新擬合六個系統,並檢查相較於 OpenAI 系統,任一 Gemini 3 模型使用自身標註者需求矩陣時,推斷出的剖面是否移動較多。
資料來源#
-
What AI Benchmarks Actually Measure: Adapting Convergent and Discriminant Validity to Interrogate Fifty-Six AI Benchmarks — Desai 等人,arXiv 2609.08812,2026-09-08,COLM 2026,
empirical。本文僅在上方關聯段落引用:§4.1–4.2 與表 D.4(能力組內 − 組間 ρ −0.00;安全性不收斂)。完整討論見 Benchmark Convergent and Discriminant Validity -
Using profiles of cognitive capability to assess AI suitability for workplace tasks — Jonathan Prunty、Marko Tešić、Patrick Quinn、José Hernández-Orallo 與 Lucy Cheke(University of Cambridge / UK Department for Science, Innovation and Technology / Universitat Politècnica de València),Using profiles of cognitive capability to assess AI suitability for workplace tasks,arXiv 2608.25623,2026-08-26,44 頁,技術報告,
empirical——保留原分級。程式碼、評分規準與基準標註已於github.com/Kinds-of-Intelligence-CFI/Task-Suitability-Profiles公開。本文引用 §3.1(能力、評分規準、基準建構、評分者間篩選、分群)、§3.1.3 與 §A.2–A.3(Measurement Layouts、差距、soft-min 彙整、截距可識別性)、§3.2(問卷工具與彙總)、§3.3(冪平均適配性)、§4.1–4.4(恢復分析、剖面、任務重要性、映射、敏感度、Company X)及 §5.1(限制)。COI:作者承認接受 Accenture 支持,且一位共同作者(Quinn)任職於英國政府部門;該部門也委託進行論文動機部分所引用的 AI 採用研究。參與企業未具名。論文未提供利益衝突聲明。解析備註。 原始檔由 docling 衍生(2.126.0 / docling-mlx 0.1.1,confidence_grade: excellent),且沒有任何[!note]/[!warning]修補區塊,因此所有表格都視為未修補。表格 1、2、4、5、6、A2、B2、C5 與 C6 已依pdftotext -layout(第 5、6、10、11、12、22、30、33 頁)逐格核對,並確認位元完全一致;表 1 的 22 個項目數加總也與其列印總數 19,576 相符,表 B2 的邊際總數兩個方向都相符。表格 A1、A3 與 B1 為定義性文字表,已與內文交叉核對。表格 C9 與 C10 在 docling 解析中嚴重錯位且黏連——數值滑入相鄰欄位(C9 第 1 列讀為3.64 [3.41, 3.87] 3.16,而 PDF 有清楚分為兩行的儲存格),第 2 列起,平均值/信賴區間也拆散到不同列。兩表均已依第 40 頁確認為受損;本頁與 wiki 其他部分均未引用這兩表的數字。本文引用的領域層級適配性與部署優先度數據僅取自 §4.4 文字。圖表依兩階段圖片規則檢視(依序確認圖表與圖片對應關係,image_000000–image_000006分別為圖 1、2、3、4、5、6、B1):圖 3 的雷達圖確認表 C6 的形狀排序,以及 Gemini 3.1 Pro 在 APS 的突出表現;圖 5 的森林圖確認 log S 約為 4.1–4.6 / 3.3–4.1 / 1.7–3.4 的分組、GPT-4o mini 在建立融洽關係活動上的提升,以及寫程式的區間最寬。圖 4(18 × 16 任務能力熱圖)已檢視,但交付解析度不足以辨讀個別儲存格,因此未從圖中讀取任何數字——本頁共同核心的發現來自 §4.3.4 文字。有一項論文內的算術說明已核對並調和,未列為問題:表 A2 註記指出兩位標註者都有效評分的項目有 19,531 個,而論文自行解釋這與 19,535 個基準項目之間的四項差異(基準只要求保留的 16 種能力有有效評分)。
Cited by 14
- Benchmark Convergent and Discriminant Validity
Cognitive Capability Profiling — the one-capability-or-many question with dimensionality fixed by…
- Benchmark Score Redundancy
Cognitive Capability Profiling — the collinearity problem one level below the score matrix, on…
- Economic Benchmark Construct Validity
Cognitive Capability Profiling — the one-capability-or-many question with the axes swapped, and a…
- Exposure Taxonomy: Observed, Theoretical, Reported, Anticipated
Cognitive Capability Profiling — an eighth instrument, and the first whose primitive is neither a…
- GDPval Benchmark
Cognitive Capability Profiling — the capability-decomposed counterpart, and the comparison neither…
- Item Response Theory for LLM Benchmarks
Cognitive Capability Profiling — the same measurement family with the difficulty parameter sourced…
- Machine Self-Report Psychometrics
Cognitive Capability Profiling — psychometrics for models, pointed the other way, from the same…
- Measuring Beyond Accuracy Saturation
Cognitive Capability Profiling — the third answer to "an aggregate score tells you little," and the…
- Evals & Benchmarks
Cognitive Capability Profiling — Prunty et al. (Cambridge CFI) put AI systems and workplace tasks…
- Open Questions Dashboard
Cognitive Capability Profiling: Does an annotator that is also a subject bias its own profile?…
- Open Questions Backlog
Cognitive Capability Profiling ×3 (oldest 6d) — Does capability-profile suitability correlate with…
- Returns to Expertise in Agentic Coding
Cognitive Capability Profiling — the complement this page names, excluded by construction from the…
- Task Crossover
Cognitive Capability Profiling — a candidate mechanism for crossover, measured from the cognitive…
- Task Saturation: Broad but Shallow AI Diffusion
Cognitive Capability Profiling — a cognitive account of the broad-but-shallow shape. Prunty et al.…
Related articles
- Economic Benchmark Construct Validity
Zhu's psychometric audit of a hash-pinned Artificial Analysis snapshot (421 configurations × 12 benchmarks, four econom…
- Open Questions Backlog
Generated by `_system/lint.py --write-backlog`. Do not hand-edit. Domain and Watching sections carry one row per page —…
- Usage-Telemetry Classifier Validation
Google ATLAS is the first AI-usage-economics program to publish accuracy numbers for the LLM classifiers every such stu…
- Exposure Taxonomy: Observed, Theoretical, Reported, Anticipated
Four distinct ways to measure AI's reach into an occupation — observed exposure (tasks seen done with Claude), theoreti…
- Item Response Theory for LLM Benchmarks
Score a benchmark with a 3PL IRT model instead of percent-correct and two separable things follow. Scoring: whole-bank…