資料來源#
- CS329A Self-Improving AI Agents — Part 4: Learning from Feedback with Tools and Code
- ExecCritic: Learn to Test, Test to Improve for Coding Agents
摘要#
RLEF——以執行回饋為 code LLM 奠基——是 CS329A 第 4 堂課三篇論文中的第二篇,也是將 ReAct 的觀察通道轉化為梯度的那篇。動作是生成的程式碼;觀察是執行程式碼後發生的事;獎勵是二元的通過/失敗。這篇文章對本 wiki 的價值,不在於執行回饋有效——可驗證性論證的整體脈絡已預測程式碼是簡單案例——而在於課堂深入討論的兩項具體設計選擇,以及錯誤分析揭露的機制。
證據。 CS329A Self-Improving AI Agents — Part 4: Learning from Feedback with Tools and Code(Aakanksha Chowdhery 個人授課,於 2025-10-03 授課,2026-08-03 發布,
practitioner-opinion)。RLEF 論文不在raw/中;課堂沒有提及作者姓名,而所有圖表都是透過 ASR 從投影片讀取的。結果來自 Llama 3.1,課堂也註明以授課當時而言「有點舊」——因此應將其視為 2024 年左右的示範,於 2025 年底重新講述。數據為約略值,來源歸於課堂內容。
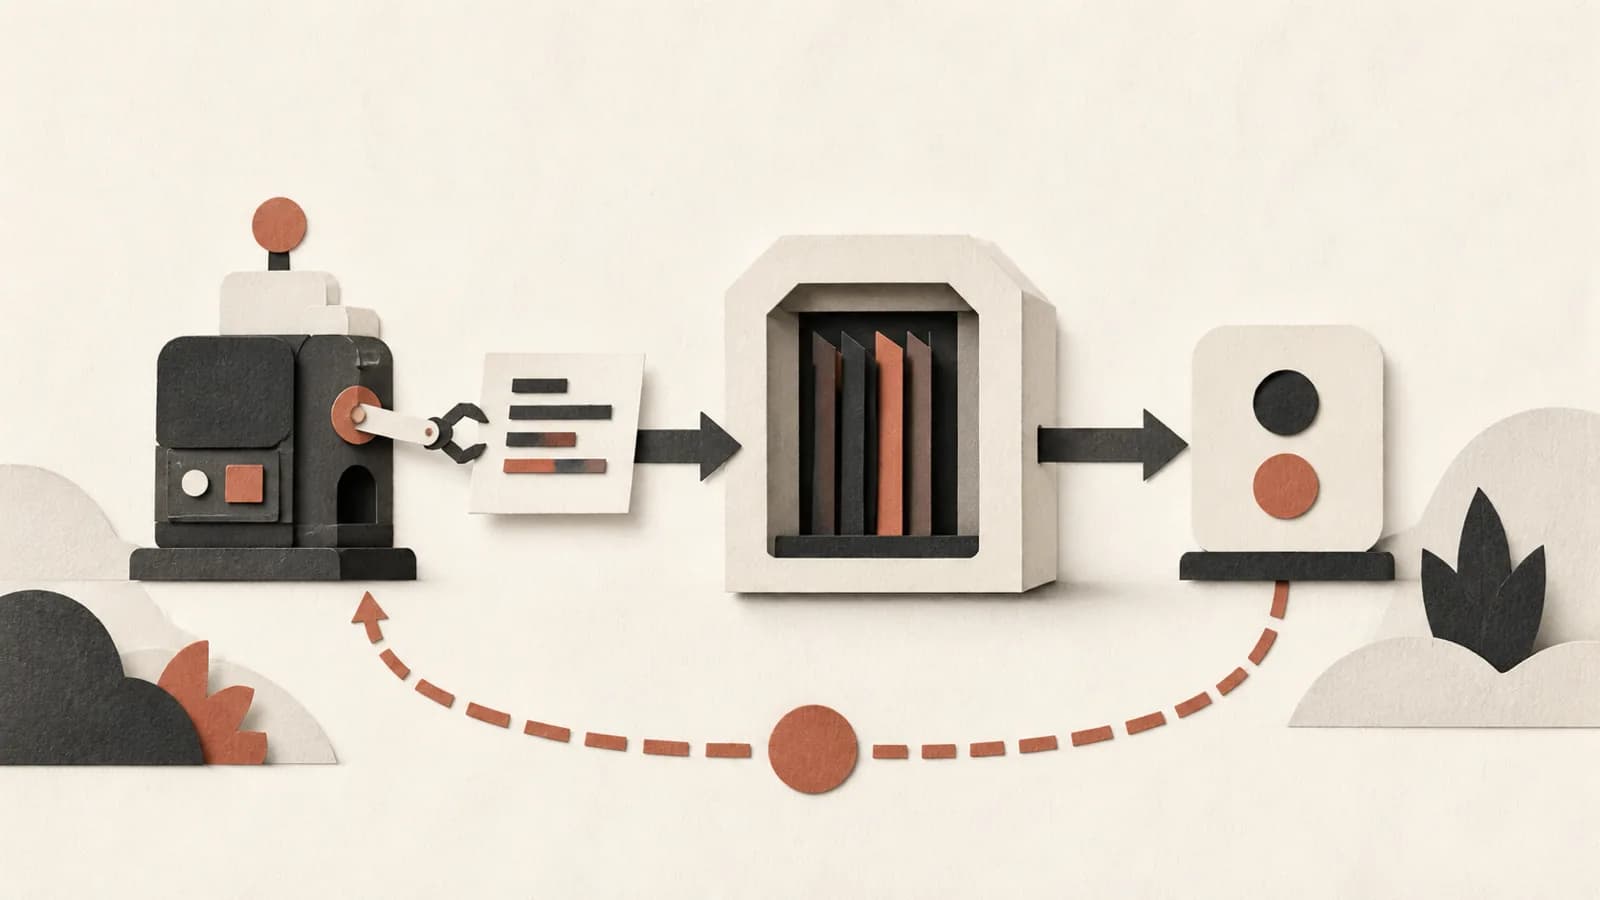
循環流程#
兩個階段都使用同一個回饋訊號,這正是此設計的重點:
- 輸入自然語言問題描述。
- 模型輸出程式碼解答,並以一組公開測試執行驗證。
- 若失敗,就將執行回饋——例如失敗測試的輸出,如執行逾時——附加至上下文,讓模型再次嘗試。這會重複進行,直到程式碼通過,或回合預算用盡。
- 將最後留下的解答交由模型從未看過的私人測試集評分,產生二元獎勵。
- 以該獎勵驅動 PPO 更新。
課堂將步驟 2–3 描述為 RL 的利用階段——讓目前的 policy 經歷推論時回饋循環——而步驟 4–5 則是 policy 更新。因此,同一套測試執行機制既是代理程式的環境,也是獎勵函數,兩者唯一的區別在於讓模型看到哪些測試。
課堂示範的例子是回文子字串問題:第 1 回合產生一個看似正確、但速度很慢的實作,在公開測試中因執行逾時而失敗;模型讀取回饋後進行最佳化並通過;接著將最佳化後的解答送至私人測試集取得獎勵。
設計選擇 1:雙層測試切分#
公開測試是小型子集——「為了更快迭代而使用的小型子集」——模型可在上下文中看見。生成期間,私人測試始終隱藏,僅用於計算獎勵。課堂提出的目的如下:
- 快速內迴圈。 小型可見測試集讓每回合迭代的成本低廉。
- 避免記住答案鍵。 「這是一種讓模型無法只靠記住測試輸出來作答的方法,因為它收到的是執行回饋。」 模型學會對失敗作出反應,而不是重現一組固定的預期值——這是一種以資訊不對稱而非獎勵塑形建立的 Reward Hacking 防護,也與 Optimizer–Evaluator Decoupling 中留出驗證器的原則相同:生成器能讀到的內容,都會成為它最佳化的對象。
這裡的論證不太穩固,課堂也承認了這點。 有學生提出顯而易見的問題——為什麼不把所有測試都放進可見迴圈,並用結果執行 PPO?——但回答始終沒有說清楚。Chowdhery 提出「他們想要比公開測試更細緻的回饋,這樣兩邊就不會有資訊洩漏」;學生追問,既然全部都是訓練資料,為什麼洩漏會重要;最後對話以*「我們可以稍後私下討論……這裡有一點術語上的落差」*作結。這項切分被呈現為一項有用但理由尚未釐清的創新,而本文也照此記錄。另請注意,兩層測試都來自同一個基準測試的測試套件,由實驗者加以切分——現實環境中並不存在這種公/私測試區分。
設計選擇 2:token 層級 policy、回合層級 value#
第二項創新是 actor–critic 配對兩部分之間的不一致。policy 逐 token 生成程式碼。value function 則以回合層級計算:對整段回應評估一次,從 prompt 的最後一個 token 讀取結果,產生*「適用於所有 token 的單一 advantage 值」*。
Chowdhery 本人將其定位為「比較接近 GSPO 的做法」——以序列層級而非逐 token 分配信用。對這項比較有兩點補充,都是本文作者的看法:GSPO 的出現晚於 RLEF,因此這是教學上的回溯參照,而非系譜主張;而且在本 wiki 唯一一項受控的長時程比較中,GSPO 的得分不高於純 GRPO,所以「像 GSPO 一樣以序列層級處理」描述的是信用分配的粒度,並非對它的背書。
這使 RLEF 成為 Turn-Level Credit Assignment 的清晰先驅,只是信用分配旋鈕設定在最粗的檔位:每個多回合 episode 配一個 advantage;TRACE 的整體貢獻,則是把這個數值拆分到它跨越的動作—觀察邊界上。RLEF 的回合正是 TRACE 的信用單位,只是它不會區分各回合。
結果顯示什麼,以及背後的機制#
主要結果。 在 CodeContests(競技程式設計)上,以取樣預算為橫軸繪製的解題率——驗證集與測試集,x 軸採對數刻度——顯示 RLEF 在整個預算範圍內都明顯較高。課堂摘要指出,RLEF 「降低了達到最先進解題率所需的預算」。這是重複取樣在訓練階段的對應做法:推論時不必透過增加樣本來提高涵蓋率,而是把曲線往上推,讓所需樣本數變少——這正是第 2、3 堂課主張測試時計算最終應轉移的方向。它也能泛化至其他程式碼生成基準測試,課堂將此歸因於 CodeContests 比遷移目標更難。
奏效的原因和直覺不同。 課堂明確指出,基礎模型*「無法只靠取得錯誤解答與執行回饋而受益」*——只給模型看它自己的錯誤程式碼和錯誤訊息,本身不會帶來任何效果。增益來自以逐回合修正進行訓練。
支援這項說法的投影片列出了第 1、2、3 回合的錯誤數量,並同時列出程式碼變更次數與錯誤類型;投影片比較了一個較小模型和一個較大模型。呈現出的趨勢如下:
- 使用 RLEF 時,錯誤輸出會隨著回合推進而減少——後續回合會修復特定失敗。
- 沒有迭代迴圈時,修改*「並不正確」*——模型雖然修改程式碼,卻無法逐步收斂。
因此,依照 Chowdhery 的說法,模型會同時利用兩件事:各次嘗試間的樣本多樣性,以及因為看得到錯誤位置而進行的針對性修改。RLEF 建立的能力是修復,而非首次嘗試就正確——課堂隨即指出,這可能是缺陷而非優點(下文詳述)。
消融實驗中有一個反向訊號,解釋得並不充分。 有學生觀察到,RLEF 產生較少單純答錯的輸出,卻產生更多逾時錯誤。課堂提出的答案——解答仍不正確,因此測試執行超時——並未真正區分這兩種錯誤;課堂最後退回「很多情況都非常依賴領域」。本文將其記為尚未解決;經修復訓練的模型產生更多逾時,正如你預期的情況:模型學會修補語義問題,卻忽略複雜度,而課堂內容沒有排除這種可能。
課堂提出的限制,以及講師承認之處#
學生提出三項質疑,Chowdhery 全都接受,沒有替方法辯護:
- 二元獎勵可能只因為問題簡單才夠用。 CodeContests 的問題比真實工程工作*「小得多」。有學生認為,較難的問題需要錯誤追蹤或其他中繼資料才能知道如何除錯;講師回答:「這很有可能。」* wiki 對執行回饋需要包含什麼,除此之外沒有其他立場;截至 2025 年底,前沿問題就在這裡。
- 獎勵可能教模型做錯事。 獎勵依據最終解答,因此沒有任何機制促使模型在第 1 回合就答對——模型可以學會依賴修復。Chowdhery 回應,推論時的回饋本來就會給模型好幾次機會;但這並未回應質疑。
- 流程獎勵與結果獎勵在此仍未有定論。 有人問逐步回饋是否會勝過終端二元獎勵,她將問題交由第 3 堂課的討論處理,並表示爭論尚未解決——「在每個領域、每個基準測試中,你可能都得做出不同的選擇。」
至於 SFT 與 RL,她給出領域內常見的區分,但沒有宣稱已得出定論:對任何領域內的任務,使用推理軌跡進行監督式微調「肯定會開始帶來價值」;而 RL 則能讓模型對新問題「多一點泛化能力」——這與 Alignment Fine-Tuning (AFT) 在對齊領域劃定的分布內/分布外界線相同。
擴展至無法放進 prompt 的問題#
課堂的第二個討論問題,將 RLEF 和真實軟體工作連結起來:程式碼庫放不進上下文視窗時,該怎麼辦?學生提出先搜尋再行動(重用 ReAct 的工具迴圈,在生成前收集所需資訊)、逐檔摘要,以及在儲存庫中採用圖譜/RAG 式檢索。Chowdhery 總結說,這正是*「實際在 Claude Code 中運作的方式」*——搜尋相關內容、套用修補程式,再執行測試——她指出 SWE-bench 是以此為目標的基準測試,並提及 Mirhoseini 實驗室的 CodeMonkeys 也在研究同一問題。
wiki 的解讀是,這會把 RLEF 清晰的訊號拆成兩個很不對稱的部分。測試通過獎勵移植到程式碼庫時仍原封不動。檢索部分——代理程式有沒有找到正確的程式碼來修改——則沒有對應的獎勵;因此,回合層級信用分配和工具邊界的上下文管理才會是獨立的研究計畫,而非這項工作的細節。
相關連結#
- CS329A: Self-Improving AI Agents (Stanford) — 第 4 堂課討論的第二篇論文;這是課程回饋來源分類法在程式設計領域的實例
- Aakanksha Chowdhery — 講師
- Reasoning–Acting Interleaving (ReAct) — 同樣的生成/觀察/修訂交替模式,但層級更高,發生於推論時且沒有梯度;RLEF 則是把這個迴圈放進訓練過程,並獎勵最後一回合
- Turn-Level Credit Assignment — 直接後繼方法。RLEF 對整個多回合 episode 分配一個 advantage;TRACE 的整體貢獻,是將這個數值拆分到 RLEF 涵蓋但未加區別的動作—觀察邊界上,其信用單位就是 RLEF 的回合
- Group Relative Policy Optimization (GRPO) — 取代 RLEF 的 PPO 加 critic 的目標函數系列。課堂自己的比較對象 GSPO(序列層級信用分配)也在該頁;在受控的長時程基準測試中,其得分不高於純 GRPO
- Process vs Outcome Reward Models — RLEF 是純結果獎勵(測試通過與否),完全沒有步驟標籤;課堂也明確不對流程監督是否勝過它表態
- Agent-Generated Test Quality — 關鍵假設,以及衡量此假設的地方。RLEF 的整體訊號仰賴測試套件定義「正確」的含義;AIDev 的統計發現,代理程式撰寫的測試在 Java 中執行了 61.5% 的變更行數,在 Python 中則為 27.0%,因此在真實程式碼庫中承載這種獎勵的測試,只涵蓋代理程式所修改內容的一小部分
- ExecCritic: Learn to Test, Test to Improve — 延伸至儲存庫規模的後繼研究,回答 RLEF 的二元獎勵假設留下的問題。RLEF 以 CodeContests 訓練,公開/私人測試切分來自同一套精心整理且已確認正確的基準測試套件;到了儲存庫規模,沒有人會提供配對測試,因此 ExecCritic 另行訓練一個 Test agent,並衡量測試本身可能有誤時會發生什麼事——固定 Repair agent 不變時,不可靠的生成測試會讓解決率低於無測試基準(61.2%→57.3%),可靠測試則會提高解決率(→65.3%)。這和本文提出的回饋豐富度開放問題(堆疊追蹤與單純通過/失敗)屬於不同面向:ExecCritic 有界限的 PASS/FAIL 回饋並不比 RLEF 更豐富,但回饋是否有幫助,首先取決於測試有效性——而豐富度問題要等這項前提成立後才談得上
- Single-Rollout Optimization — 從信用估計角度提出相同的環境回饋問題:SAO 的 skip-observation GAE 假設環境回應沒有值得傳遞的價值訊號;它提出的開放問題也指出,編譯器錯誤和測試結果正是可能推翻此假設的案例。RLEF 是以端到端方式訓練的測試結果案例,但沒有 GAE 對照組,因此它加深了疑慮,卻無法解決問題
- Reward Hacking — 私人測試層是一種結構性防護:將獎勵的輸入從生成器的上下文中隱藏,而非試圖塑造生成器看得見的獎勵
- Optimizer–Evaluator Decoupling — 以架構方式表達相同原則;公/私測試切分是在訓練迴圈內實作解耦
- Efficiency Debt of AI-Generated Code — 該頁的開放問題已經提出完全相同的流程,也提醒我們謹慎看待此做法:RLEF 的獎勵只檢查測試是否通過,不會反映執行效率;而課堂自己也發現 RLEF 訓練產生了更多逾時錯誤,卻沒有解釋原因。通過/失敗獎勵可能會訓練模型修正語義問題,卻忽略複雜度
- Latent Capability Overhang — RLEF 取代的推論時替代方案:透過增加樣本提高解題率,或提高解題率曲線來減少所需樣本數
- The Verifiability Thesis — 有測試套件的程式碼是本 hub 中最容易驗證的領域,而 RLEF 展現了驗證器不需成本時,飛輪會如何運轉
- Tool-Output Pruning — 將循環流程擴大到儲存庫規模後,尚未計價的成本:每個失敗回合的執行輸出都留在上下文中,供下一回合作為條件
- Large-Scale Test-Time Compute — RLEF 改變的解題率對預算曲線,以及它所展現的將取樣遷移至訓練階段的方向
- Offline Multi-Step Tool-Use RL (SWiRL) — 三天後同一門課提出的刻意相反設計:RLEF 讓程式碼執行結果成為獎勵訊號;SWiRL 則完全將工具執行從 RL 迴圈中移除,改為依據所提查詢的品質給予獎勵,因為好的搜尋查詢在執行前就能評估
- The Data Wall and the Validation Commons Are One Supply Constraint — 若將這個迴圈視為資料供應結果,而非訓練結果:當執行結果就是獎勵時,不需要人在迴圈中就能製造經驗證的訓練資料,這正是程式碼不受資料牆限制的原因;而在勞動力方面,這也說明程式碼是能力門檻到來時不必耗用任何 validation commons 的領域
- Selection Under a Submission Budget — RLEF 所取代的取樣成本。AlphaCode 2 將約 95% 無法編譯或答錯的生成結果丟棄;有學生詢問如何減少這種浪費時,講師提出兩個答案:自我修正,以及提高解題率曲線的 RL 迴圈,讓較少樣本就能達到相同結果
- Post-Scarcity Macroeconomics — 執行回饋是低成本且可靠的驗證器之一,決定 Stockfish 門檻首先落在哪裡;這就是為什麼到達順序和驗證需求彼此相關,而非互相獨立:最先自動化的領域,正是人類驗證者從未扮演關鍵角色的領域
開放問題#
- 課堂承認,二元通過/失敗訊號只在簡短且自成一體的問題中足夠。更豐富的執行回饋——堆疊追蹤、失敗輸入、涵蓋率差異——會改善獎勵,還是只改善原本就存在的上下文內修復訊號?兩者可以分開處理,但課堂將它們混為一談。
- RLEF 訓練修復能力,而非首次嘗試正確與否;獎勵無法區分兩者。以此方式訓練的模型,在單次生成上是否能測得比 SFT 基準更差——也就是以不含回饋時的 pass@1 換取經過 k 回合後通過?
資料來源#
- CS329A Self-Improving AI Agents — Part 4: Learning from Feedback with Tools and Code — CS329A Self-Improving AI Agents — Part 4: Learning from Feedback with Tools and Code,Aakanksha Chowdhery 個人授課,Stanford Online。於 2025-10-03 授課,2026-08-03 發布至 YouTube(
practitioner-opinion,YouTube 自動字幕逐字稿,約 12.9k 字)。課堂約三分之一討論 RLEF:訓練/推論回饋迴圈及其利用/更新之分、回文範例、雙層公開/私人測試策略及尚未解決的學生洩漏問題、token 層級 policy/回合層級 value 設計及其 GSPO 比較、Llama 3.1 在 CodeContests 上解題率對取樣預算的結果(包含對數刻度 x 軸及跨基準測試泛化)、顯示針對性修復的逐回合錯誤分析、未經解釋的逾時錯誤增加,以及承認的三項限制(二元獎勵用於簡單問題、沒有首次回合的壓力、流程與結果獎勵仍未有定論)。此外,課堂也討論了程式碼庫放不進上下文的問題,提及 SWE-bench 和 CodeMonkeys。RLEF 論文不在raw/中,課堂未提及作者姓名;所有圖表都是 ASR 從投影片讀取,因此本文採取保留態度
Cited by 23
- The Data Wall and the Validation Commons Are One Supply Constraint×3
Where the verifier is free, the loop closes and the human input can be deleted entirely. RLEF puts…
- Aakanksha Chowdhery×2
Her first solo lecture (delivered 2025-10-03) is the course's pivot from how good is the verifier…
- CS329A: Self-Improving AI Agents (Stanford)×2
Execution Feedback Rl — lecture 4's second: the interpreter as reward function, with a two-tier…
- ExecCritic: Learn to Test, Test to Improve×2
ExecCritic (Tao, Peng, Wang, Wang, Cheng, Yao, Wu, Ge, Li & Gao — University of Wisconsin-Madison /…
- Guarantees That Degrade at Deployment: Action-Space Soundness, Admissibility Without Effect, and a Vendor-Coupled Security Framework×2
Concept pages: Reasoning Acting Interleaving, Continuous Self Modification Under Review, Zero Trust…
- Offline Multi-Step Tool-Use RL (SWiRL)×2
This is process supervision built out of a prompted judge on action proposals, and it is exactly…
- Reward Hacking×2
Execution Feedback Rl — a guard built from information asymmetry instead of reward shaping: RLEF's…
- Agent-Generated Test Quality
Execution Feedback Rl — where test quality becomes a training signal rather than a safety net.…
- Alignment Fine-Tuning (AFT)
Execution Feedback Rl — the same lecture's other self-improvement loop, and the contrast that gives…
- Efficiency Debt of AI-Generated Code
Execution Feedback Rl — the pipeline this page's open question asks for, plus a reason to expect it…
- Group Relative Policy Optimization (GRPO)
Execution Feedback Rl — the PPO-with-a-critic generation this objective replaced, and where the…
- Latent Capability Overhang
Execution Feedback Rl — the training-time alternative to buying coverage with samples. RLEF's…
- Model Capability & Training
Execution Feedback Rl — Train a coding model with the interpreter in the loop: generate code, run a…
- Open Questions Dashboard
Post Scarcity Macroeconomics: If validation capacity is a commons and the Stockfish threshold is…
- Open Questions Backlog
Execution Feedback Rl ×2 (oldest 43d) — Binary pass/fail is conceded to be sufficient only for…
- Optimizer–Evaluator Decoupling
Execution Feedback Rl — this rule implemented inside a training loop rather than around one: the…
- Post-Scarcity Macroeconomics
If validation capacity is a commons and the Stockfish threshold is reached unevenly across domains,…
- Process vs Outcome Reward Models
Execution Feedback Rl — a pure outcome reward with no learned verifier at all: a hidden test suite…
- Reasoning–Acting Interleaving (ReAct)
Execution Feedback Rl — lecture 4's second paper and the same loop with the observation replaced by…
- Selection Under a Submission Budget
Execution Feedback Rl — the other route out of the sampling bill, and the one the lecture points at…
- Single-Rollout Optimization
Execution Feedback Rl — the execution-feedback case this page's open question names, trained end to…
- Tool-Output Pruning
Execution Feedback Rl — the unpriced context cost of an execution-feedback loop: every failed…
- Turn-Level Credit Assignment
Execution Feedback Rl — the coarse ancestor. RLEF puts a coding agent's public-test failures back…
Related articles
- Process vs Outcome Reward Models
The four-year arc of trained LLM verifiers as taught in CS329A lecture 3: OpenAI's GSM8K verifier (score the finished s…
- CS329A: Self-Improving AI Agents (Stanford)
Stanford's graduate course on self-improving agents, taught by Azalia Mirhoseini and Aakanksha Chowdhery (Autumn 2025,…
- Large-Scale Test-Time Compute
Noam Brown's thesis that model capability is now a function of inference budget (tokens/cost/time): with good scaffoldi…
- Open Questions Backlog
Generated by `_system/lint.py --write-backlog`. Do not hand-edit. Domain and Watching sections carry one row per page —…
- The Verifiability Thesis
LLMs automate what you can *verify* as computers automate what you can *specify*; RL verification rewards → jagged peak…