資料來源#
摘要#
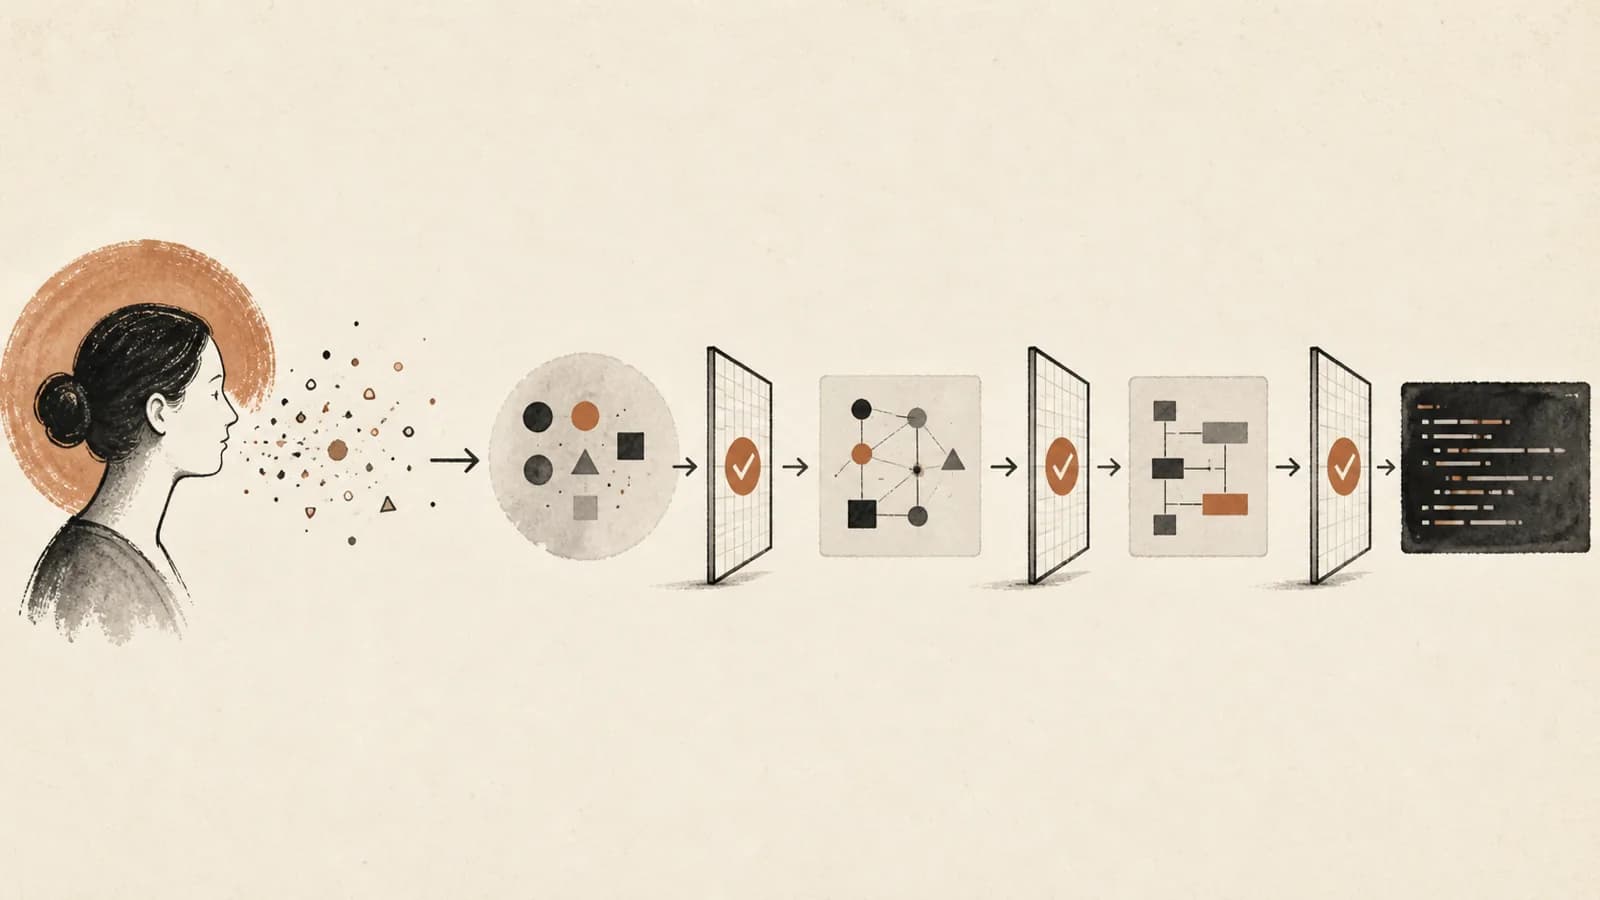
Santi Weight 是 Bridgewater's Pocket Analyst Tool 的技術負責人,具備編譯器理論與程式語言設計背景。他在演講結尾提出的思想實驗,實際上就是這場演講的論旨:**把代理式編碼視為編譯器問題,而非代理程式問題。**這個類比談的是結構:編譯器會把使用者程式碼轉換為 JavaScript 等目標;程式設計代理則會把使用者提示或計畫轉換為 Python。驅動這個做法的是需求特性:人們期待編譯器具備確定性、正確性與可靠性,而對避險基金來說,這正是讓它願意把生成的分析用於數十億美元交易決策底層所需的特性。「我們不能只靠氛圍編碼的分析,來支撐這些分析的運作。」
主張不只是編譯器是個好比喻,而是四十年的編譯器技術——具型別的中介表示、依賴圖排程、平行降階、強制驗證階段、靜態分析與快取——都能直接移植過來,而且移植後能取得光靠提示要求相同行為所無法帶來的特性。以下四項做法各自都是編譯器技術,執行著明確可辨識的編譯器工作。
計畫是具型別的 IR,而非待辦清單#
聊天代理會產生分析計畫;程式設計代理則會消費這份計畫。計畫會拆解成任務,每項任務大致對應一個計算單一資料框架的 Python 函式。任務的結構包含名稱、要計算內容的描述,以及最關鍵的部分——描述預期輸出資料框架的結構與語意資訊。
Weight 明確說明兩者的差異:「我們的分析計畫不只是像你在 Claude Code 會看到的待辦清單。相反地,我們把它視為一個自然語言 Python 專案。」待辦清單列出意圖;這種計畫則列出介面。兩者的差異就像建置指令碼與連結器的差異:一旦每項任務都宣告自己會輸出的形式,其他任務就能根據該宣告編譯,而不必依賴產出的成品。
這裡也是刻意投入規劃成本的地方。Michael Ran 將規劃階段描述為「從時間角度來看相對昂貴,但我們刻意支付這筆成本,因為它能讓我們在執行期間做到某些事」;這個階段要列出分析中的每個資料框架、其結構,以及所有資料框架彼此如何連結。同一項決策從投資端的說法——「計畫就是分析」——在規劃與執行的分工中已有探討;本文關注的是,一份型別資訊足夠完整的計畫能為下游編譯器帶來什麼。
平行降階,以及它為何不只是扇出#
由於每項任務都宣告自己的輸出結構與依賴項結構,所有任務的程式碼都可以同時生成:「計畫末尾的視覺化任務,已經知道自己要從尚未完成的資料載入程式碼生成中取得哪些內容。」消費端是根據宣告編譯,而非根據已產出的成品——這就是分離編譯的特性,讓 C 專案只憑標頭檔就能平行建置所有翻譯單元。
這項做法附帶兩個自述數字。與 Claude Code 相比,在上下文和計畫相同的情況下,PAT 生成程式碼的速度約快 4 倍。至於擴展的樣貌:20 項任務的計畫所需的總耗時,大致與 3 項任務的計畫相同,Weight 稱之為「超級擴展」。
這兩個數字都應狹義解讀。只要有足夠的並行上限,任何容易平行化的扇出都能讓耗時不隨任務數增加,這部分並不令人意外;真正重要的主張是,這種扇出不會犧牲品質,因為每個子代理程式都是根據完整介面編譯,而非靠猜測。演講並未測量這一點。4 倍的數字比較的是一條針對特定領域的專用管線,與一個從未以具型別計畫為輸入格式的一般用途代理;而且,就像本文集其他「確定性勝過自主性」的結果,沒有消融實驗能分離出究竟是哪個要素帶來成效:計畫型別、平行處理,以及下方的執行層都同時在變。代理程式程式碼審查的確定性工程也有同樣缺少的對照組;確定性的執行前閘門則將其稱為本文集至今尚未執行的實驗。
在架構中強制驗證,而非在提示中要求#
生成完成後,管線會對輸出的程式碼執行靜態分析、推導出DAG,再在各個依賴層級平行派遣驗證代理程式——「五項任務的計畫會形成三個層級,而 20 項任務的計畫可能形成四或五個驗證層級。」每次驗證都會將生成的程式碼與產生它的任務相比;若不相符,就編輯程式碼並反覆執行。
這正是 Weight 最希望大家記住的架構主張:
「我們在架構中強制正確性。再說一次,沒有代理式編排。這是一般的 Python 程式碼,所以防護措施非常嚴格,而且代理程式不可能忘記驗證。它們會被強制驗證。」
他指出,高階架構圖「其實只是 Python 程式碼。它受到 LangGraph 影響,但沒有代理式編排。」兩者的差異在於:代理程式被指示執行的驗證步驟,可以被跳過、忘記,或判定為不必要;但如果驗證步驟是外層程式的一行指令,代理程式就無法略過。這與 fail-closed 執行階段閘門(確定性的執行前閘門)、規則驅動的派遣器(代理程式程式碼審查的確定性工程),以及將驗證過的行為提升為零 token 確定性路徑(將代理程式工作結晶為工作流程)採用的是同一種手段——只是往上移了一層,轉而用於代理程式本身的編排,而非其工具呼叫。
執行層:由模型之外的程式碼代為執行,再加上快取#
Weight 提出的第二項架構反轉是:程式設計代理通常會透過終端工具呼叫自己的生成程式碼。他點出兩項成本——工具呼叫往返的延遲,以及代理程式「有時會在過程中迷失方向」。PAT 則代表模型執行程式碼,透過自訂框架執行;該框架使用傳統靜態分析管線,將快取註記注入 Python 程式碼,以避免重複執行。
首次執行的效益不大,機制也很明確:PAT 不會重複載入資料,也不會重複執行中間產物。**真正的主張關乎第二次執行。**他們的基準測試取一份已完成的計畫,只更改最後一張圖表的名稱。Claude Code 會重新執行所有內容——「基本上花費相同的時間,不過編輯程式碼的速度較快」;PAT 的執行則「幾乎是即時的」。對使用者而言,產品上的效益才是重點:投資人可以小幅調整分析,而不必每次都付出完整迭代的成本。
請留意比較中坦承的一點:**Claude Code 編輯本身的速度較快。**優勢不在生成速度,而在於記憶化的依賴圖能縮小小幅編輯的影響範圍;代理程式重新呼叫自己的指令碼時,並沒有表示哪些內容未曾改變的方式。
95% 確定性數字的含義與不含義#
可靠性方面最醒目的主張是:「我們對任何計畫執行測試套件時,有 95% 的情況下,兩個不同代理程式輸出的程式碼完全相同。所以這基本上就是一個確定性的程式設計代理。」背後的設計意圖則另外表述為對任務規格的要求,而非任何模型本身的特性——「我們期待每項任務都能透過 LLM 確定性地編譯成一段程式碼。因此,兩個 LLM 處理同一個任務時,執行後應產生語意等價的程式碼——輸出值相同,而且完全一致。」
有三種解讀值得分開看,因為演講將它們混為一談:
- 設計上的期待是語意等價(輸出值相同)。回報的測量結果則是文字完全相同(程式碼「完全相同」)。文字相同是更強的特性,也更容易測量;只要規格夠嚴謹,輸出空間就能被壓縮到足以達成這一點,即使從未檢查語意是否相同也做得到。
- **95% 是在修復迴圈之後測得的。**生成、驗證與程式碼編輯都會在比較之前執行,因此這個數字混合了兩件事:具型別的計畫對首次輸出的約束有多嚴密,以及驗證層讓兩次不同執行收斂至同一固定點的可靠程度。這是兩種不同的工程成果,失敗模式也各不相同;但演講將功勞歸於前者,測量的卻是在後者完成之後。
- **採用確定性是為了打造評估的基礎設施,而非把它當作終點。**Weight 說明其效益:「因為我們有高度可重現的代理程式,在持續擴大規模、逐步改進和評估時,能用上比憑感覺或 LLM-as-a-judge 評估可靠得多的東西。」可重現的管線能讓基準測試差異歸因於你所做的變更,而非抽樣雜訊——這正是Production-Sourced Evaluation和Measuring Beyond Accuracy Saturation都提到的 LLM 裁判變異性問題。這是本文最容易移植的主張,卻完全沒有附上數字。
先專精,再複合——方向只有一種#
演講的第一項重點,是從架構推導出的策略結論。Bridgewater 明確不相信通用且強大的代理程式:「它們能做出很酷的示範……但要把它變成可靠的日常工作流程,真的很難。」建議的順序是狹窄工作流程 → 大量基準測試 → 逐步改進 → 組合,並附帶方向性的主張:「之後你可以再把代理程式組合起來,但要反過來做就比較難。」
這種不對稱性是值得關注的部分,但目前只有主張,沒有驗證。它表示將專用代理程式透過組合泛化,成本低於透過限制來專精通用代理程式;若此說法成立,談的就不只是何種架構較好,也涉及產品生命週期的哪個階段必須採用具型別計畫的方法。演講並未測試這一點。
關聯文章#
- 規劃與執行的分工——從另一側觀察相同的規劃與執行分工。該文的遙測發現是描述性的(觀察到的 Claude Code 對話中,人類約做出 70% 的規劃決策,代理程式則約做出 80% 的執行決策);PAT 的架構是規範性的做法,刻意付出昂貴規劃階段的成本,以讓執行可以平行且可檢查。Ran 所說的「計畫就是分析」,是本文從產品端表達的說法;本文從編譯器端主張,正確性的預算應花在 IR 上
- 代理程式程式碼審查的確定性工程——本文集中另一項「限制代理程式,勝過一般用途基準」的成果,也是方法上最接近的對照案例:兩者都將專用管線與 Claude Code 比較,也都回報大幅倍數差異,但都沒有執行消融實驗,因此兩者都未驗證各種確定性注入措施分別有何貢獻。差異也值得借鏡——OpenCodeReview 的確定性體現在派遣與輸出限制,主要成果是精確率與召回率的取捨;PAT 的確定性體現在 IR 和執行層,主要成果是延遲與可重現性,完全沒有回報品質指標
- 確定性的執行前閘門——相同的執行階段強制手段,但往下一層。閘門是對提議的工具呼叫進行純粹判定;PAT 的驗證層則是對提議的程式執行強制階段,並由執行階段推導的 DAG 排程,而非由代理程式自行決定。兩篇文章都建立在同一項尚未證實的前提上——架構勝過指令——而且都缺少能證明此主張的「僅有指令」控制組
- 將代理程式工作結晶為工作流程——生命週期上的對照。Malik 會根據累積證據,將反覆驗證過的代理程式行為沿著光譜逐步推向零 token 的確定性程式碼;PAT 則是從一開始就以確定性為設計前提,結構取自領域本身,而非依靠實績逐步取得。兩者描述了通往相同目的地的相反起點;PAT 的做法之所以可行,只因領域的形狀(分析是資料框架 DAG)早已明確
- 同一推理軌跡內的平行規劃(SPRINT)——把同一項 DAG 還原洞見運用在推理軌跡內,而非跨越計畫:SPRINT 發現一連串思路其實暗藏依賴圖,並將互相獨立的步驟重新編排成平行執行。PAT 不必還原圖形,因為具型別的計畫已將其宣告出來——兩者差異在於推斷 IR 或直接取得 IR
- 動態工作流程:代理程式的代數——最接近的第一方類比,也是差異最鮮明之處。Claude Code 的動態工作流程同樣會在沙箱中以一般程式碼組合代理程式,但程式由模型撰寫;PAT 的編排程式則由人類撰寫並固定不變,因此「代理程式不可能忘記驗證」才會是一項保證,而非一種傾向
- 模型改進時的 harness 精簡——值得一提的另一種觀點。精簡論主張,隨著模型進步,支架會被移除;PAT 的 harness 卻精密而且持續擴大(具型別 IR、驗證 DAG、靜態分析快取層、自訂執行框架),作者也預期這些元件會繼續承擔關鍵功能。兩篇文章提出的調和方式是:精簡適用於取代模型能力的支架;若強制執行機制提供的是模型無論能力高低都無法自行提供的保證,就不會隨模型進步而縮減——精簡論本身也承認機械式驗證屬於這種情況
- 驗證成為新的瓶頸——驗證被移入編譯器的階段結構中,因此不必另外耗費人力步驟,也無法被跳過;此外,本設計還有一種特有的第二層驗證:PAT 在交付前會自行檢查完成的分析,確認數字合理、圖表清晰,也就是「初階分析師會再次檢查自己的工作」這一步
- Bridgewater Associates——該組織、讓機器可讀領域脈絡得以建立的 50 年書面投資邏輯,以及建構 PAT 的多種專業類型團隊結構
開放問題#
- 以計畫作為具型別 IR 的方法,能否移植到工作無法拆解成可宣告結構的 DAG 的領域?本文的每項特性——平行降階、分層驗證、記憶化重複執行——都源自 Bridgewater 的分析本身就是資料框架依賴圖。任何人只要能在開放式程式設計領域(重構、事件回應)中回報相同架構以及延遲或可重現性數字,就能驗證此說法
- 兩個代理程式之間 95% 的程式碼一致率,究竟是具型別計畫的特性,還是驗證修復迴圈的成果?顯而易見的消融實驗——測量驗證前輸出的一致率——就能區分兩者,而且採用此架構的人很容易執行。在測試之前,「基本上就是一個確定性的程式設計代理」把功勞歸給 IR,但修復迴圈可能才是實際完成這項工作的環節
- 「先專精再複合」的方向性主張是否成立——也就是狹窄且經基準測試的代理程式,往上組合的成本是否低於通用代理程式往下專精的成本?這是演講中最具關鍵性的策略主張,卻沒有附帶任何證據
資料來源#
- How Bridgewater Built an AI Analyst That Does Hours of Expert Research in Minutes — Brendan McManus、Michael Ran 與 Santi Weight(Bridgewater Associates 應用 AI 團隊),How Bridgewater Built an AI Analyst That Does Hours of Expert Research in Minutes,LangChain channel,2026-07-24,25:44 的會議演講,
case-study。本文取材自 Weight 的技術段落(18:08–25:29),以及 Ran 對規劃與執行的解說(11:14–14:27)。證據處理方式:本文中的數字全是第一方自述,且未交代方法——程式碼生成快 4 倍、20 項任務與 3 項任務耗時相同、兩個代理程式有 95% 的程式碼一致率,以及執行層的兩項基準測試結果,都是根據投影片提出,沒有公開任務集、樣本數、模型或日期;而且比較基準 Claude Code 是一個一般用途代理,評估時並未採用 PAT 管線所使用的格式。應把這些數字視為有利害關係方提出的方向性主張,而非測量結果。逐字稿未收錄投影片視覺內容,包括架構圖和兩張基準測試圖表
Cited by 11
- Crystallizing Agent Work into Workflows×3
bridgewater pat ai analyst — McManus, Ran & Weight (Bridgewater Associates), LangChain channel,…
- Bridgewater Associates×2
Two architectural properties of the deployment are treated in depth elsewhere: the compiler-shaped…
- Deterministic Engineering for Agent Code Review×2
Agentic Codegen As Compilation — the corpus's third determinism-beats-autonomy claim, and the third…
- Deterministic Pre-Execution Gates×2
Agentic Codegen As Compilation — the same enforce-in-the-runtime lever moved up a level, from the…
- Dynamic Workflows: An Algebra for Agents×2
Agentic Codegen As Compilation — the nearest architectural analogue with the authorship reversed,…
- Intra-Trace Parallel Planning (SPRINT)×2
Agentic Codegen As Compilation — the same DAG-is-hiding-in-there insight, one level up and with the…
- Measuring Beyond Accuracy Saturation×2
bridgewater pat ai analyst — McManus, Ran & Weight (Bridgewater Associates), LangChain channel,…
- Open Questions Backlog×2
Agentic Codegen As Compilation ×2 (oldest 42d) — Does the plan-as-typed-IR discipline transfer to a…
- Planning / Execution Division of Labor×2
Agentic Codegen As Compilation — the prescriptive counterpart to this page's descriptive telemetry.…
- Agent Systems & Harness Engineering
Agentic Codegen As Compilation — Bridgewater's PAT treats a coding agent as a compiler, not an…
- Production-Sourced Evaluation
Agentic Codegen As Compilation — the reproducibility argument for why an eval substrate needs a…
Related articles
- Cost-per-Task Over Cost-per-Token
Anthropic's inverted model-selection default: start with the most capable model and dial effort down — a stronger model…
- Agent-Authored Harness Optimization
An agent runs the whole eval-fix loop on its own harness — read traces, hypothesize, patch, re-run. Seven instances dis…
- Open Questions Backlog
Generated by `_system/lint.py --write-backlog`. Do not hand-edit. Domain and Watching sections carry one row per page —…
- Verification as the New Bottleneck
Fiona Fung: coding is no longer the bottleneck — verification, review, maintenance are; shift-left; TDD loses its tax;…
- Agent Quality Flywheel
Google's eval-fix loop packaged as a skill your coding agent drives: Build & Test → Ship & Monitor → Learn & Refine, ex…