資料來源#
摘要#
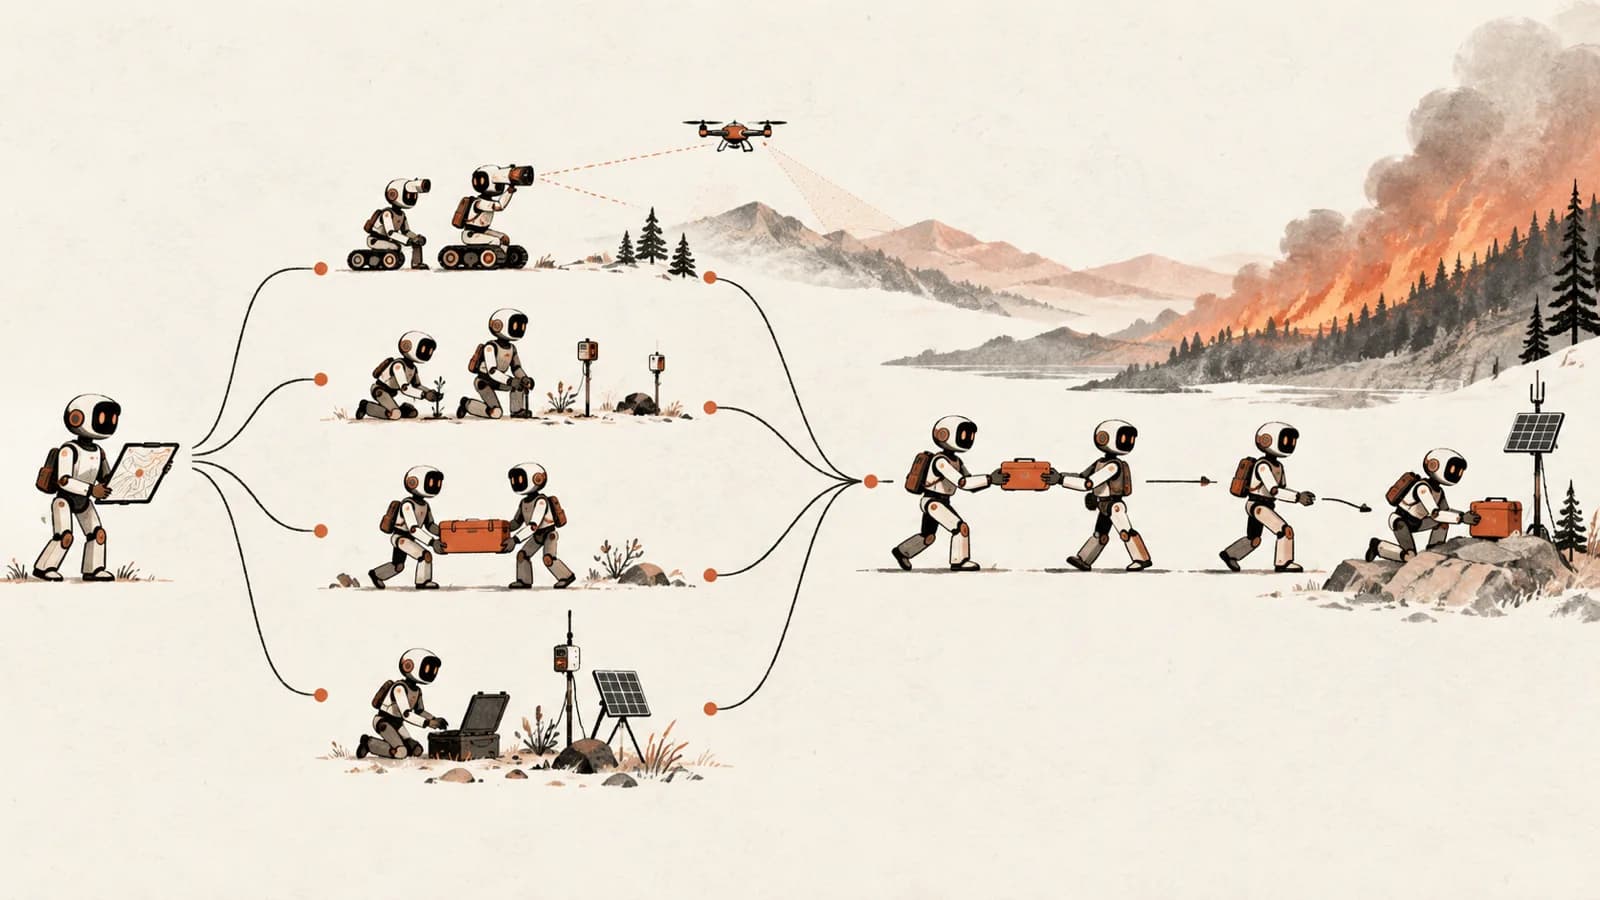
多數具身多代理程式 LLM 系統會選定一種通訊拓撲(扁平、集中式、管理者/工作者),並將它套用到每項任務,不論任務規模或結構為何。ORCH(Zhengran Ji、Jonathan Hyun 與 Boyuan Chen,Duke,arXiv 2609.11737,2026-09-10,empirical)則將人類組織理論中的兩項概念——彙集相依性(對共同成果做出彼此獨立、同時進行的貢獻)與序列相依性(依序進行的工作,其中某階段的產出是下一階段的先決條件)——操作化為兩種可組合的管理者類型,並依據任務描述 T、可用工作者 W 及其能力 C,建立量身打造的階層 G = H(T, W, C),階層可由人類專家或搭配評論模型的 LLM 建構。
研究以擴充版 CREW-Wildfire 基準測試進行驗證:25 項野火應變任務(原版為 16 項)、最多 50 個分屬四種工作者類型的異質具身代理程式、五個隨機種子、八個基礎 LLM,並與四種具代表性的固定結構基準(CAMON、COELA、HMAS-2、Embodied)比較。人類設計的 ORCH 階層平均提升最終分數 63.97%、執行效率 74.29%;由評論模型監督生成的階層則分別提升 43.63% 與 52.53%。這項增益不會因執行任務的 LLM 而顯著不同(Type-II ANOVA),也不隨模型規模變化。
運作機制:兩種管理者類型,而非角色標籤#
- 水平管理者(彙集相依性)將並行任務分派給其子級——工作者或子管理者——形式為
T_h = f_h(M, P, R):輸入任務M、估計進度P和子級回報R,輸出一組(子級、任務)指派。 - 垂直管理者(序列相依性)不會直接分派任務。它會先將任務拆解成有序階段序列
Φ = {φ_1 … φ_K} = f_v(M, P_m, R),只啟動目前階段、為該階段產生指派,並且只有在該階段的完成條件達成後才進入下一階段。 - 兩者可以遞迴組合——垂直管理者可監督水平管理者,協調某階段中的並行工作;水平管理者也可監督本身由垂直/水平管理者混合組成的子團隊——複雜任務因此能形成「團隊中的團隊」,簡單任務則維持單一扁平管理者。
- 通訊是雙向的,而且每個環境時間步都會進行,不只在設定時進行一次。由下而上:每位工作者回報完成狀態、目前狀況或緊急資訊;每位管理者彙整子級回報,以估計進度並決定繼續、修訂、進入下一階段或完成任務。由上而下:決策從根節點傳到葉節點;在確定新計畫之前,子級會評估指派是否可行,並可提出可採取行動的異議,迫使計畫在執行前修訂。
- 自動生成時,語言模型會提出階層,再由評論模型檢查工作者數量、能力與責任是否相符、是否有不必要的層級,以及提出的群組是否對應真實子目標;接著依據評論修訂提案,直到收斂或逾時。
在本文的協調架構脈絡中,這項結構差異值得精確區分:水平與垂直管理者是不同的規劃功能,也採用不同的通訊節奏(垂直管理者的階段門檻會確實扣住下一批指派,直到條件達成),而非在原本扁平的迴圈上加一句「你是執行長」的指示。另見下文的 Parallel Agent Orchestration,可直接比較兩者。
基準測試與比較基準#
擴充版 CREW-Wildfire 測試集涵蓋 25 項任務,從 3 個代理程式的單一角色任務,到 50 個代理程式、四種工作者類型、200 個時間步的任務,並納入明確的任務中突發事件(無人機失聯、直升機故障、新增平民、第二處火災)。四種工作者類型各具互補且不重疊的能力:消防員(通用能力:清除植被、救援、補水、滅火)、推土機(只能快速清除植被)、無人機(只能偵察)、直升機(長距離運輸與水上作業)。每次執行追蹤六項評估指標——最終分數、執行效率(表現相對進度的 AUC)、探索程度(涵蓋區域),以及三種成本指標(每步 API 呼叫數、輸入詞元數、輸出詞元數)——依任務難度加權彙整,並在八個 LLM 上取平均(ChatGPT-5.4、Gemma-4-it、Llama-4-Scout-16E、ERNIE-4.5、Qwen-3.6、Nemotron-3-Super、GLM-5.1、DeepSeek-V4-Pro)。
四種基準涵蓋此領域主要的協調架構:CAMON(去中心化、由通訊觸發的動態領導)、COELA(去中心化、具獨立規劃/記憶/通訊模組的認知架構)、HMAS-2(混合式集中與去中心化:全域規劃者依工作者回饋修正)、Embodied(固定、由提示詞指定的組織結構)。
結果#
- 論文摘要直接陳述的主要結果:「相較於四種先前架構,人類設計的 ORCH 組織平均提升最終分數 63.97%、執行效率 74.29%。語言模型自動生成的組織則分別提升這些指標 43.63% 與 52.53%。」
- **所有 LLM-任務-隨機種子組合中的第一名占比:**人類設計 ORCH:32.6%(最終分數)/31.1%(效率);LLM 生成 ORCH:26.2%/25.0%;CAMON:16.2%/19.5%;Embodied:12.1%/13.3%;HMAS-2:5.8%/6.3%;COELA:7.2%/4.8%。
- **Type-II ANOVA:**演算法對最終分數(F₄,₉₃₆ = 9.21, p < 0.01)及效率(F₄,₈₉₃₆ = 6.68, p < 0.01)有顯著主要效果——兩個 F 統計量的自由度在原文中跳變,且未加以說明;語言模型與任務在兩項指標上也都達顯著;演算法 × 模型的交互作用則不顯著(最終分數 F₃₂,₉₃₆ = 0.90, p = 0.62;效率 F₃₂,₉₃₆ = 0.63, p = 0.93)。ORCH 的優勢能跨越八個 LLM 泛化,而非由某一種有利配對所帶動。
- **集體表現不會隨模型規模單調提升。**中等規模模型 Gemma-4-it 與 Qwen-3.6 的 ORCH 整體表現最強,優於 ChatGPT-5.4、GLM-5.1 與 DeepSeek-V4-Pro;儘管較大型模型在其他地方的程式設計與數學推理基準上領先。論文作者的解讀是:模型規模與集體能力並不能互換;集體所需的能力(遵循角色、精簡摘要狀態、區分平行與序列工作、將指示轉成可行動作),並非單模型基準測量的項目。
- **結構品質與結果品質相互呼應。**對生成階層計算的六項樹狀指標(深度、平均工作者深度、平均管理幅度、管理幅度變異、管理者數量、工作者深度變異)呈現一致排序:人類設計的階層最淺且最均衡(樹深度 1.20、管理幅度變異 1.48、工作者深度變異 0.00);由評論模型監督的 LLM 階層緊隨其後(1.31、5.08、0.025);未經評論模型的階層則更深且較不均衡(1.56、7.48、0.031,且管理者數量最多,為 2.08)。檢視發現,沒有評論模型的生成方式會引入不必要的管理者與層級。
- 失敗模式分析(每種方法執行 1,000 次,由 DeepSeek-V4-Pro 閱讀完整通訊記錄並分成五類):人類設計/評論模型監督的 LLM/無評論模型的 LLM ORCH 成功率分別為 53.1%/42.2%/35.2%,四種基準則為 6.9–13.5%。基準失敗主要來自工作者執行(51.2–64.5%)及錯誤任務分派(14.7–28.1%);ORCH 大幅降低工作者執行失敗(降至 13.1–20.7%),但使其餘失敗往上游移動,轉為任務分派問題(人類設計 8.4% → 評論模型監督的 LLM 21.0% → 無評論模型的 LLM 29.6%)及適應問題(13.6% → 17.6% → 18.8%)。三種 ORCH 變體的協調/通訊失敗率都維持在低點(0.7%),基準最高則達 7.1%。
- **具體案例(Scale Level Complex,難度最高的任務):**在 200×200 地圖上使用 50 個代理程式(25 名消防員、10 架無人機、10 架直升機、5 台推土機)。人類設計的階層由一名垂直管理者監督五名水平管理者,將任務拆成四個依序階段(偵察火場/水源/平民 → 空中確認與監控 → 為地面單位補給並安排位置 → 建造防火帶並滅火),每個階段都由相關水平管理者群組執行彙集式並行工作。
這項研究為本文脈絡增添了什麼#
為「組織形式是否重要」這個問題開拓了新領域,而且是個規模很大的領域。Multi-Agent Collective Intelligence 提出的開放問題是:多代理程式規模化是否取決於組織形式或任務複雜度?迄今大多數答案來自軟體代理程式協調(OrchBench 的模擬計畫、Anthropic 的奇幻遊戲群集)、社會困境遊戲(Shi et al. 的跨供應商社會困境),以及完全沒有 LLM 代理程式的控制理論測試平台。ORCH 在第五個領域提供 6,000 次真實具身代理程式執行(5 個隨機種子 × 8 個 LLM × 25 項任務 × 6 種演算法),並在組織形式這個面向給出明確答案:讓階層形狀符合任務的相依結構,能大幅勝過固定結構,而且優勢穩定跨模型。此設定涉及具嚴格資源與時間相依性的實體任務,其協調需求可能比這個脈絡中任何先前來源都更接近人類組織類比原本提出的情境。
確認相同區分的是機制,而非提示詞文字;這是第二個領域的證據。Parallel Agent Orchestration 已收錄 Anthropic Frontier Red Team 的一項負面結果:在原本扁平、執行 12 小時的代理程式群集中加入「規定角色」或「執行長階層」等提示詞文字,「沒有太大差異」;相較之下,Cursor 專門打造的協調機制(將程式碼與設計文件連結的具型別、由編譯器強制執行的參照;中立的合併仲裁代理程式)確實帶來可測量的效果。ORCH 在另一領域提供了第二筆支持相同區分的資料:它的水平/垂直管理者是不同的規劃功能,並設有強制階段門檻,不是在單一迴圈上加裝角色文字;其增益(63.97%/74.29%)遠大於本文脈絡中任何純提示詞介入所帶來的成果。這並非在同一系統中控制實驗「結構與文字」的消融測試——ORCH 沒有測試自身框架的純文字版本,Anthropic 也沒有在其群集中測試結構化階層——因此這種比較是相互佐證,而非決定性證據。
**自動設計協調結構仍需要外部檢查,再添一例。**由評論模型監督的 LLM 生成階層,大幅縮小但未完全消除與人類設計的差距(相同基準下分別為 43.63%/52.53% 與 63.97%/74.29%);在結果分數呈現差異之前,樹狀結構指標便已顯示落差(階層較深、較不均衡)。OrchBench 的 LLM 生成任務 DAG 也呈現相同現象:其中 34.3% 在使用前遭其 LLM 評審拒絕。這兩個不同領域、兩種不同「結構」意義的結果都指出,模型提出的協調結構可用,但尚未能自行驗證。
限制與注意事項#
- **沒有只針對結構的消融測試。**論文明確區分有無評論模型,但沒有拆分「任務特定階層」、「階段門控排序」與「帶異議的雙向回饋」各自帶來多少增益。四種基準在上述所有面向都同時與 ORCH 不同,而且彼此的架構也不同。
- **階層在建構時即固定。**計畫、階段及指派會在執行期間調整,但樹狀結構本身不會在任務中途重組;作者明確將此列為未來工作。
- 失敗分類由 LLM 產生,且未經獨立驗證——DeepSeek-V4-Pro 根據通訊記錄,為自身與其他所有方法的失敗分類,沒有經過人類評審檢查;作者也將此列為限制。
- **單一實驗室、單一基準系列。**使用
empirical等級有其根據(受控、多隨機種子、多模型、統計檢定),但 CREW-Wildfire 及其擴充版都是該研究團隊自建的測試平台;程式碼已公開(github.com/generalroboticslab/ORCH),但截至本次收錄尚未有獨立重跑結果。 - 解析備註。
docling在原始文件偵測到的 8 張表中,標記了 11 個儲存格有table-collapse問題。三張包含可引用數據的表(S1:任務配置;S2:分數公式;S3:符號定義)已依據來源 PDF 的pdftotext -f 60 -l 62 -layout交叉核對,與原始 Markdown 的數字逐字元相符,其中包括 Scale Level Complex 這一列(25 名消防員/5 台推土機/10 架無人機/10 架直升機),也與上文具體案例的敘述相互核對。其餘遭標記的儲存格位於 Algorithm 1 的偽程式碼中,解析時呈現為數張小型管線表;本文未引用其中內容(演算法改以正文與上方方程式說明),因此此標記不影響本文任何數字。
延伸閱讀#
- Multi-Agent Collective Intelligence ——為「多代理程式規模化是否取決於組織形式或任務複雜度」這個開放問題,增加第五個具身代理程式領域;這是該脈絡中跨模型資料集最大的一項研究,並對組織形式面向給出明確答案(任務特定結構勝過固定結構);同時也是集體表現不隨模型規模變化的第二個獨立案例
- Parallel Agent Orchestration ——呈現機制與提示詞文字的差異:Anthropic 在扁平群集中加入「規定角色」/「執行長階層」提示詞,影響不大;ORCH 在另一領域以結構不同的水平/垂直管理者類型,讓結果變化數十個百分點。這是相互佐證,並非針對同一系統的控制消融測試
- Orchestration-Plan Simulation ——在另一領域呈現同樣的模式:自動生成結構需要評論模型。OrchBench 自行生成的任務 DAG 有 34.3% 在使用前遭 LLM 評審拒絕;ORCH 未經評論模型的階層在結構上較差(較深、較不均衡),得分也較低;評論模型則縮小了大部分、但非全部的人類設計差距
開放問題#
- 本文沒有分別消融任務特定的階層形狀、評論模型監督、階段門控或異議與修訂回饋迴圈——相較於四種基準,究竟是哪一項帶來 ORCH 的優勢?
- 階層建構完成後便固定,只有計畫、階段與指派會在執行期間調整。若在任務中途重組樹狀結構,能否進一步縮小人類設計與 LLM 生成之間的差距?還是無論執行期間如何調整,設計階段的品質才是主要因素?
資料來源#
- Organizational Principles Enable Collective Intelligence in Embodied AI ——Ji、Hyun 與 Chen(Duke University),Organizational principles enable collective intelligence in embodied AI,arXiv 2609.11737,2026-09-10,
empirical,100pp。正文:Introduction 與「The challenge of organizing embodied artificial collectives」說明研究動機及扁平/單一管理者的失敗模式;「A testbed for organizational intelligence」說明 CREW-Wildfire 擴充版(25 項任務、四種工作者類型、任務中突發事件);「Organizing agents through pooled and sequential interdependence」與「Task-specific organizational hierarchies」說明水平/垂直管理者形式(Eq. 1–3)及由評論模型監督的生成流程;「Closed-loop execution through hierarchical communication」說明由下而上/由上而下的通訊協定及異議與修訂步驟;「Results」全文涵蓋主要百分比、ANOVA 表、模型規模非單調變化、樹狀指標比較(Figure 5B)與失敗模式細分(Figure 5C);「Discussions」則收錄作者對模型規模結果的解讀,以及明列的未來工作限制(任務中途不重組階層、分類未經人類驗證)。Supplementary Text §S1(Algorithm 1,完整偽程式碼)已依據正文方程式交叉核對;表 S1(任務配置)已依據pdftotext -f 60 -layout驗證——詳見上方限制與注意事項。**解析警告:**原始文件偵測到的 8 張表中有 11 個儲存格遭標記為table-collapse問題;承載關鍵數據的表格(S1–S3)已完成核對,且是本文唯一引用數字的表格——遭標記的儲存格位於 Algorithm 1 偽程式碼的管線表中,本文未引用
Cited by 5
- Parallel Agent Orchestration×4
Task Specific Organizational Hierarchies — the mechanism-beats-text split reproduced in an embodied…
- Multi-Agent Collective Intelligence×3
Task Specific Organizational Hierarchies — a fifth domain (embodied wildfire-response robotics) for…
- Open Questions Backlog×2
Task Specific Organizational Hierarchies: The hierarchy is fixed once built; only plans, phases and…
- Agent Systems & Harness Engineering
Task Specific Organizational Hierarchies — ORCH (Ji, Hyun & Chen, Duke): human-organization-theory…
- Orchestration-Plan Simulation
Task Specific Organizational Hierarchies — the same critic-needed-for-automated-structure pattern…
Related articles
- Open-Ended Discovery Harnesses
Harness designs for hours-long agent runs on problems with no known optimum, where the recurring failure is idea collap…
- Client-Side Agent Optimization
AgentOpt's framing of developer-controlled agent optimization (model-per-role, budget, routing) as distinct from server…
- Dynamic Workflows: An Algebra for Agents
Claude Code's sandboxed orchestration primitive: Claude writes and runs a program that composes agents in sequence and…
- Parallel Agent Orchestration
One human overseeing a team of concurrent agents: OpenAI Codex telemetry's first hard numbers (28.6% of staff peaked at…
- Ticket-Driven Agent Orchestration
The inversion that makes Symphony work: tickets as units of work (not sessions/PRs), DAG dependencies, agent-extensible…