資料來源#
摘要#
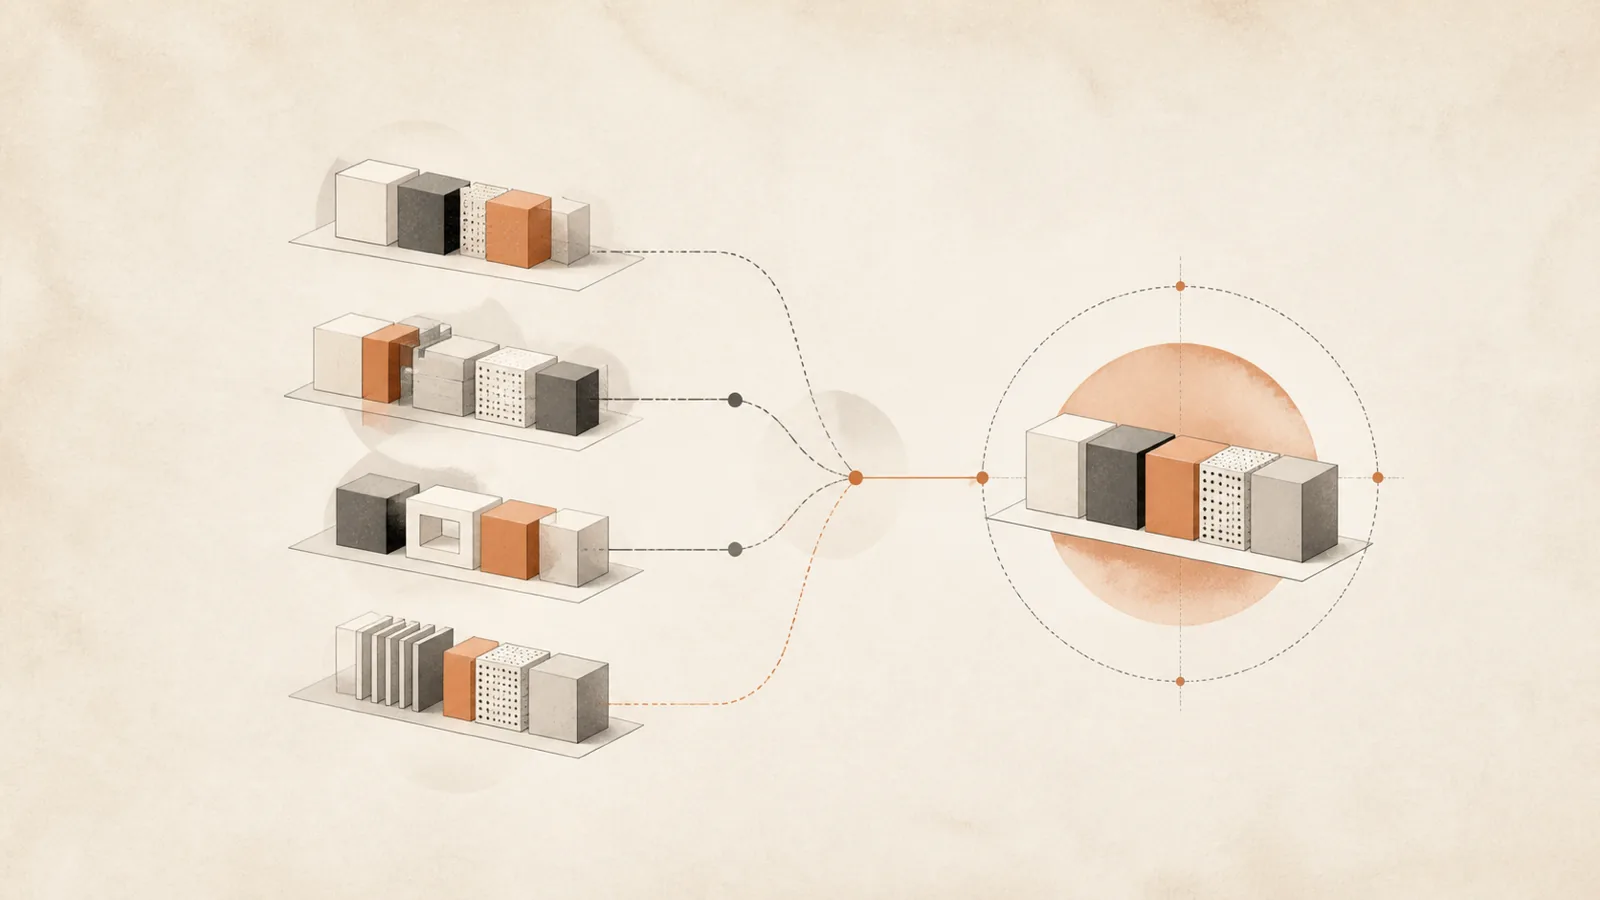
一旦接受能力是推論預算的函數,接下來的問題就不是要花 多少,而是該以 什麼形式 花費。Archon——由 Azalia Mirhoseini 在 CS329A 第 2 講介紹(於 2025-09-26 授課、2026-08-03 發布,practitioner-opinion,轉述她實驗室自身的研究)——把形式本身設為搜尋目標來回答這個問題:推論時架構是由多層堆疊而成,每層都是套用於一組模型的單一提示操作;系統會在推論呼叫預算內,自動搜尋這個堆疊,以符合目標基準。
其構想是:輸入包括 (a) 一組目標基準、(b) 推論呼叫預算、(c) 一組可用的 LLM,以及 (d) 一組推論時技術。最佳化器 ITAS(推論時架構搜尋)會回傳一種架構——使用哪些模型、哪些操作、操作順序為何,以及要多寬——以在預算內最大化準確率。整套系統都靠提示運作,不會進行微調。「我們沒有——我們並沒有訓練模型去執行這項特定的測試時擴展任務。」
操作集合#
每項操作都是提示,因此搜尋空間能以低成本建構,卻需要高成本評估:
| 操作 | 功能 |
|---|---|
| 生成 | 從模型取樣 n 個回答——也就是重複取樣這項基本操作 |
| 融合 | 把問題 和全部 k 個回答 一起交給 LLM,要求它合成一個輸出答案 |
| 評論 | 描述某個回答的優點與缺點 |
| 排序器 | 為前一層的回答排序(LLM-as-a-Judge) |
| 驗證器 | 為回答評分,並回傳評分背後的推理 |
| 生成單元測試 | 讓模型為問題撰寫單元測試(程式碼、數學、推理) |
| 評估單元測試 | 讓模型依據這些測試,判斷候選答案是否正確——但不實際執行測試 |
最後這一組尤其值得注意:評估單元測試以第二次模型判斷取代實際執行,讓原本具有硬性驗證器的領域回到軟性驗證器的模式,藉此把適用範圍從程式碼延伸到數學與推理。這是 CodeMonkeys 自行生成測試的想法,只是拿掉了直譯器。
融合勝過神諭挑選#
這頁最值得記住的單一成果,因為它打破了test-time-compute相關文章都視為固定的上限。
在一項推理/QA 基準中,從單一模型取樣 1→10 個樣本,勝率依序如下:
- 隨機挑選——任選一個樣本。這是下限。
- 模型排序——請模型排序並選出第一名。已勝過隨機挑選。
- 神諭挑選——由完美驗證器從 k 個樣本中挑出最佳答案。理所當然地勝過排序。
- 融合——把 k 個樣本全部交給模型,請它合成一個答案。勝過神諭挑選。
- 先排序再融合——先篩選出前 5 名,再進行融合。表現最佳。
這項結果之所以重要,是因為生成–驗證落差的定義,就是各種挑選方法與神諭挑選器所能達到的結果之間的差距。只有當輸出必須是這些樣本中的其中一個時,涵蓋率才是上限。融合的輸出不受此限制——它可以從幾個錯誤答案的部分拼出正確答案,也可以把候選答案之間的差異當作答案的證據。Mirhoseini 的解讀是:「這種典範本身就如此強大,能讓回應品質勝過神諭挑選。」這個落差對挑選器而言確實存在,但它並不是固定樣本預算價值的上限。
將單一模型的 k 個樣本改為 k 個不同模型(異質集成,依最佳模型優先加入)後,同樣的趨勢依舊成立。隨機基準表現變差——集成中較晚加入的成員較弱——但以上排序維持不變。融合器與排序器是這組模型中最強的模型(Multi-Agent Collective Intelligence)。
堆疊中的深度就像網路中的深度#
Archon 搜尋出的架構並非只有兩步的管線。一種典型架構是:由多個模型生成 → 評論 → 排序器 → 一組融合器,各自將回應融合為單一輸出 → 再次評論 → 再次排序。至於程式碼,最佳化器找到的架構則是生成多個樣本 → 生成單元測試 → 評估。
堆疊更多層會持續帶來改善。報告中最佳的設定是模型集成,包含三層評論加融合,再加上最後一層融合;在許多任務上的表現都「顯著優於」只用一次最佳模型,或用最佳模型執行八次、再經過單一融合層的做法。Mirhoseini 明確以此類比:「就像深度學習中,我們增加層數並進行預訓練,模型就會變得更好。」
這是本文集裡最接近推論時組合具有深度效果的主張,也說明了為何這裡的說法是「架構」,而不是「管線」。這項結果來自自動字幕逐字稿中的投影片,標記為 practitioner-opinion;而且尚未與計算量相同的扁平基準比較(見下方注意事項)。
搜尋空間,但不為搜尋付出高昂代價#
評估候選架構需要大量推論,因此 ITAS 在設計上花了大部分心力,先縮小搜尋空間再進行搜尋:
- **離線預處理。**離線測試發現,生成 → 評論 → 排序器 → 融合器這個序列效果良好,因此搜尋空間以它為基礎加以限制。
- **人工限制。**每層只能使用一種推論時技術;第一層一律為生成器;排序器或融合器之前必須先有評論器;單元測試生成器之後必須立即接上評估器。
- 貝葉斯最佳化會在剩餘空間中搜尋,使用保留的訓練切分作為依據,並以特定推論呼叫預算下的準確率作為目標——目標是準確率與呼叫次數之間的前緣,而非單一數字。相較於貪婪搜尋或隨機挑選設定,這種方法「樣本效率高得多」。
限制清單正是這項成果坦承的部分:搜尋並未自行發現評論器應該排在排序器之前,而是事先收到這項指示。它真正找出的是寬度、深度與模型配置。
亮眼數字,以及為何不宜過度解讀#
只使用開源模型時,Archon 的 pass@1 表現追平或超越當時的封閉前沿模型;在指令遵循、推理、數學與程式設計任務上,平均比 GPT-4o 與 Claude 3.5 Sonnet 高 14.1%。兩種變體都有效:針對特定任務的 Archon(只對單一任務執行貝葉斯搜尋),以及通用型 Archon,目標是在多項任務上都有良好表現;即使在未經調校的任務上,它仍勝過前沿模型——課堂將這項泛化主張視為出人意料之處。
要注意,讓這項比較至少有意義的設計選擇是:Archon 恰好只輸出一個回答,因此它最佳化的是 pass@1,而不是 pass@k。這正是 Compute-Controlled Benchmarking 所要求的原則:「只有 pass@k 看得見的提升,代表嘗試次數增加,而非能力提升。」
但同一頁提出的另一項要求並未達成。Brown 對基準最大化的批評,精準點出這種做法——「讓模型執行五次並選最佳答案;加上 LLM 評審,從 N 個回答中挑出最強者」——這種讓紙面表現更好看的方式,一旦「控制測試時運算量」就會失去效果。單次 GPT-4o 呼叫與由多個模型、多層組成的 Archon 堆疊,運算量並不相同,而課堂沒有報告任何這類控制。Archon 的確繪製了自家搜尋中準確率與推論呼叫次數的關係,這比基準比較表做得更多;但它沒有把前沿基準模型放在同一個座標軸上。應將 14.1% 解讀為這種架構在此預算下勝過該模型單次呼叫。這是關於廉價模型加上結構所帶來的真實且有用的說法,而非能力比較。這個數字也是以 2025 年底的模型為對象,在 2025 年底得出的。
與 harness 自我修改的關係#
Archon 與agent-authored harness optimization是同一個想法的兩種尺度,而本文集後來的 empirical 研究則提供了兩者之間的對照:
- Archon 使用外部貝葉斯最佳化器,在離線環境中,針對保留切分,在封閉且由人工指定的操作詞彙中搜尋。搜尋的是組合,而不是程式碼。
- Harness 演化會讓中介代理程式改寫 scaffold 的原始碼,完全不受詞彙限制。Wang、Zhu、Hu 等人(arXiv 2607.12227,
empirical)將其與 K = 5 的純平行取樣做預算配對,結果發現它比什麼都不做更差(67.4 對基準 68.2),保留資料上的遷移效果則為 +0.6pp。
這些結果暗示一種解釋——尚未經過測試,值得以假設而非結論的方式提出——那就是限制本身就是價值所在。Archon 受限的搜尋空間,以及經離線驗證的層級順序,讓搜尋成本低到值得執行;不受限制的中介代理程式則會花掉同樣的預算,重新找出那套結構,而且通常會失敗。這也表示 Archon 受到 Wang 等人提出的第二項批評:若在同一類基準上搜尋並回報結果,就可能測到系統對任務模式的適應能力,而非架構品質。通用型變體的跨任務結果部分回應了這項疑慮,但還沒有完全解決。
延伸閱讀#
- Large-Scale Test-Time Compute — 本文的中心參照:這頁在「要花多少」的主張下追問「要以什麼形式」,而融合是其中唯一能勝過完美挑選器的操作
- The Verifiability Thesis — 融合是本文集裡第一個繞過生成–驗證落差的做法,而非試著縮小它,因為融合輸出不受限於樣本中的其中一個
- Latent Capability Overhang — 生成層負責重複取樣;Archon 提出一種方法,說明取得樣本後該如何運用
- LLM-as-a-Judge — 排序器、評論器、驗證器與單元測試評估器操作全都是評審,只是被堆疊使用,而不是單獨用一次
- Multi-Agent Collective Intelligence — 異質集成的部分:k 個不同模型產生的樣本交由最強模型融合,排序與單一模型的情況相同
- Agent-Authored Harness Optimization — 不受限制的同類做法:由中介代理程式改寫 harness 原始碼,而不是組合固定操作詞彙;預算配對後,這種做法表現較差
- Compute-Controlled Benchmarking — Archon 有一半符合原則(pass@1 輸出、準確率與呼叫次數的目標),另一半則違反原則(前沿基準未以相同運算量比較)
- Open-Ended Discovery Harnesses — 2026 年延伸出的相關問題:如何在寬度與深度之間分配固定預算;答案是在執行時動態調整,而非離線搜尋
- Azalia Mirhoseini — 實驗室介紹;Archon 是 Monkeys 系列的第三項成果,前兩項為 Large Language Monkeys 和 CodeMonkeys
- CS329A: Self-Improving AI Agents (Stanford) — 第 2 講將此方法教作解決生成–驗證落差的建構式答案
- Process vs Outcome Reward Models — 說明驗證器與單元測試評估器操作的組成,來自同一門課程的下一講:Archon 將 ORM/PRM 文獻中的方法視為現成層級
- Weak-Verifier Ensembling — 同一實驗室、下一講的相關研究,兩者分工清楚:Archon 將推論操作組合成搜尋出的架構,Weaver 則將驗證器模型組合為一個彙總分數。兩者都認為固定預算的配置方式比預算大小更重要,而且都著重組合而非訓練
- Tree Search over Agent Trajectories (LATS) — 同一門課程中,搜尋尺度較低的做法:Archon 離線搜尋推論操作構成的管線,LATS 則在線上搜尋環境動作構成的軌跡
- Selection Under a Submission Budget — 以第二套系統測量融合所繞過的上限。AlphaCode 的管線純粹採用挑選(篩選、分群、提交十個),因此其設計天生受涵蓋率限制;課堂指出,在最多提交十次的條件下,差距約為 30%,而不限次數則高於 40%。Archon 的融合操作在這條管線中沒有對應做法
尚待解答的問題#
- 若兩者以相同運算量比較,融合是否仍勝過神諭挑選?融合需要額外一次長上下文呼叫來處理全部 k 個樣本;神諭挑選除了產生樣本外不需額外成本。課堂繪製的是兩者與樣本數的關係,而不是與使用的 token 數量的關係。
- 為什麼融合會勝過神諭?有兩種與結果相容的機制:融合器從各自錯誤的候選答案中拼出正確答案,或是候選答案的分布攜帶了逐一挑選候選答案時會捨棄的資訊。這兩種機制對 k 增加時的擴展行為有不同預測。目前沒有資料能分辨兩者。
資料來源#
- CS329A Self-Improving AI Agents — Part 2: Test-Time Compute Scaling — Stanford CS329A 第 2 講,Azalia Mirhoseini(於 2025-09-26 授課、2026-08-03 發布,
practitioner-opinion,YouTube 自動字幕逐字稿,約 9.7k 字)。Archon 導覽涵蓋 ITAS 的構想與四項輸入、七種操作詞彙、融合勝過神諭的勝率曲線及其模型集成對照、層級深度結果、貝葉斯最佳化器與人工限制,以及 pass@1 平均高於 GPT-4o 與 Claude 3.5 Sonnet 14.1% 的結果。所有數據都是從自動字幕逐字稿中的投影片讀取,僅為近似值;尚未編譯原始論文。講者是論文共同作者,課程助教也是論文共同作者——這是已揭露的利益衝突
Cited by 16
- Tree Search over Agent Trajectories (LATS)×2
Inference Time Architecture Search — search at a different altitude: Archon searches over pipelines…
- Azalia Mirhoseini×2
Inference Time Architecture Search — Archon, her lab's third step in the line: search over composed…
- CS329A: Self-Improving AI Agents (Stanford)×2
Constructive answers. Snell et al.'s parallel-vs-sequential-vs-PRM-guided-search comparison and its…
- Weak-Verifier Ensembling×2
That makes it a sibling of Archon from the same lab and the previous lecture, and the pair divides…
- Agent-Authored Harness Optimization
Inference Time Architecture Search — the constrained ancestor. Archon (2024) searches the same kind…
- Compute-Controlled Benchmarking
Inference Time Architecture Search — a specimen that half-obeys this page and half-embodies its…
- Large-Scale Test-Time Compute
Inference Time Architecture Search — the "what shape" question made searchable: Archon composes…
- Latent Capability Overhang
Inference Time Architecture Search — what to do with the samples once you have them: Archon…
- LLM-as-a-Judge
Inference Time Architecture Search — judges used as composable operations rather than as a final…
- Model Capability & Training
Inference Time Architecture Search — Archon (Mirhoseini's lab, 2024): treat test-time scaling as an…
- Multi-Agent Collective Intelligence
Inference Time Architecture Search — a small, concrete datum for this page's "does a homogeneous…
- Open-Ended Discovery Harnesses
Inference Time Architecture Search — the 2024 ancestor of the same question. Archon searches…
- Open Questions Backlog
Inference Time Architecture Search ×2 (oldest 43d) — Does fusion still beat oracle selection when…
- Process vs Outcome Reward Models
Inference Time Architecture Search — Archon's verifier and unit-test-evaluator operations are these…
- Selection Under a Submission Budget
Inference Time Architecture Search — the operation this pipeline lacks. Archon's fusion synthesizes…
- The Verifiability Thesis
The one thing on this page that goes around the gap rather than at it: fusion. Coverage bounds what…
Related articles
- Large-Scale Test-Time Compute
Noam Brown's thesis that model capability is now a function of inference budget (tokens/cost/time): with good scaffoldi…
- Process vs Outcome Reward Models
The four-year arc of trained LLM verifiers as taught in CS329A lecture 3: OpenAI's GSM8K verifier (score the finished s…
- Compute-Controlled Benchmarking
Noam Brown's critique: the single-number benchmark grid is broken because it ignores test-time compute — plot performan…
- CS329A: Self-Improving AI Agents (Stanford)
Stanford's graduate course on self-improving agents, taught by Azalia Mirhoseini and Aakanksha Chowdhery (Autumn 2025,…
- Latent Capability Overhang
Noam Brown's claim that already-released models can do far more than anyone has extracted, because nobody spends enough…