資料來源#
- CS329A Self-Improving AI Agents — Part 6: Train-Time Scaling and Scaling RL
- CS329A Self-Improving AI Agents — Part 9: Future Research Areas
- The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement
摘要#
STaR — Self-Taught Reasoner,Zelikman、Wu、Mu 與 Goodman(Stanford,2022)——是 CS329A 這門課所命名之迴圈的最簡單可行實例,也是本知識庫中最早一個確實會改動權重的方法。它源自講座明確提出的資料問題:網際網路規模的文字不包含推理步驟;人工標註推理步驟成本高昂;根據已知解題模式自動產生資料只適用於狹窄領域;而以少數已解範例進行少樣本提示,表現不如使用較大型、只有答案的資料集微調。因此,STaR 讓模型自行製造缺失的資料。
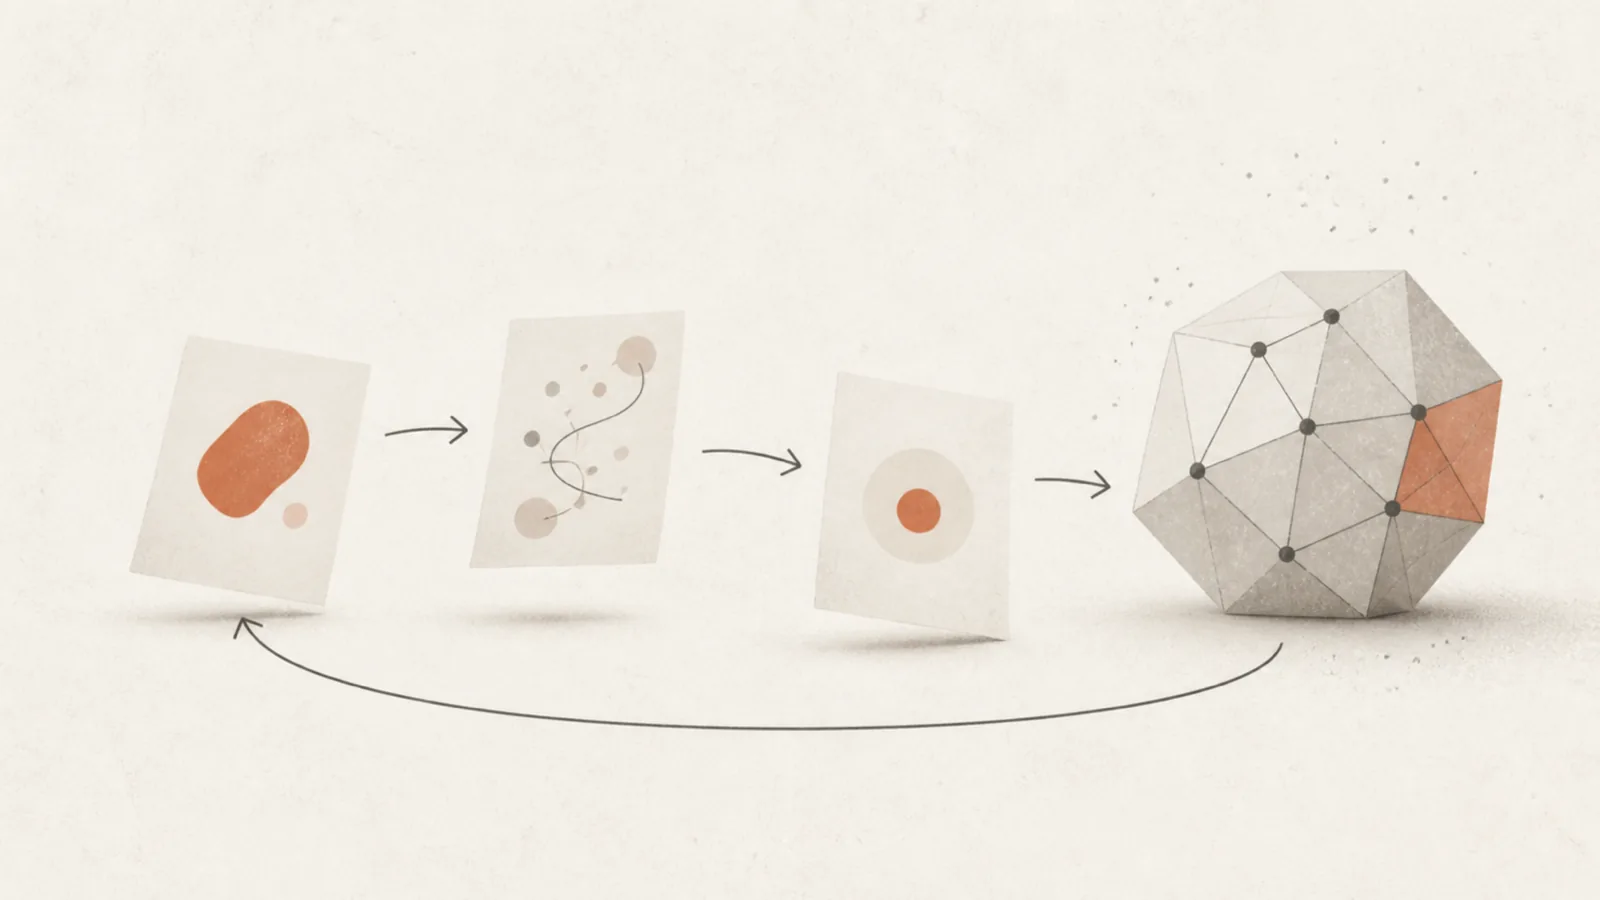
講座教的迴圈如下(Aakanksha Chowdhery,第 6 講,2025-10-10 授課,practitioner-opinion):
- 從一小組問題/推理/答案三元組,以及一大組問題/答案配對開始(實務上是基準測試的訓練集切分——答案正是篩選之所以可能的關鍵)。
- 以種子推理內容進行少樣本提示;為每個訓練問題產生推理過程與答案(講座舉例的規模:約 10k 個問題)。
- **只保留最終答案正確的生成結果。**其餘全部捨棄。
- 以保留的(問題 → 推理 → 答案)三元組微調模型。
- 重複,從改進後的模型重新生成。
若沒有步驟 3 的補充,其餘步驟就只是多繞幾圈的拒絕取樣。讓 STaR 成為獨特方法的,是它如何處理失敗案例。
Rationalization:論文的關鍵技巧#
以正確性篩選有個明顯的死路——*「如果我們只用正確範例微調,模型就無法學會如何解決新問題……基本上沒有任何訊號。」*錯誤答案恰好對應值得學習的問題,而這些也正是篩選器會丟棄的內容。
合理化會反向處理這些問題。把正確答案當作提示交給模型,要求它產生能推導出該答案的推理過程,接著將生成的(問題 → 推理 → 答案)三元組加入訓練集,**並移除提示中的答案——彷彿模型是直接自行解出來的。**如此一來,訓練集便涵蓋超出模型目前解題率的問題,迴圈也能向上自我引導,而不是只在自身能力範圍內打轉。
這是值得延伸到這篇論文之外的特性。只靠結果篩選,只會留下模型原本就會做的事;三年後 SWiRL 將這種自我設限的形式命名並加以測量(「結果篩選只保留模型原本就能解決的問題」)。STaR 的作法是為模型答錯的問題製造正向範例,而不是評分每個步驟;SWiRL 則保留最終答案錯誤之軌跡中的良好步驟。兩者從相反方向處理同一個缺口,而且都不需要流程獎勵模型才能看出問題。
三項假設,以及各自對應的失敗模式#
講座特別明確地指出,STaR 仰賴的是假設,而非研究結果:
| 假設 | 假設不成立時的問題 |
|---|---|
| 正確的最終答案可以代表推理過程正確 | 無效的中間步驟會被拿來訓練。講座承認:「中間可能會有一些無效步驟。」 |
| 已知答案時,模型能產生有效推理並導出該答案 | 有提示的推理鏈會朝著已知目標合理化——模型可能建構出看似合理、但實際上未曾採用的推理,而 STaR 完全不會篩選步驟 3 的內容 |
| 基礎模型夠強,能從少樣本範例開始自我引導 | 若問題類別超出基礎模型的能力範圍,有沒有提示都不會有結果;只有部分問題落在能力範圍內時,反覆執行的外層迴圈才有幫助 |
課堂對第二列的討論最為深入,回答是承認這項限制,並指出後續研究:「STaR 本身不會篩選合理化後的推理鏈,『但後續論文會在第三步進行篩選……可以在推理鏈上加上某種流程獎勵模型』」——也就是事後才出現的補救方法:流程監督。若沒有這項方法,唯一可用的品質檢查方式就是由人閱讀推理鏈;講師認為這很繁瑣,也不建議這麼做。
請留意這種方法帶來的特徵:整套方法的訊號完全來自結果正確性,但存在已知的偽陽性管道(答案正確、推理錯誤),而且沒有工具可以偵測——這正是第 3 講最初提出、用來支持流程監督的偽陽性案例。
講座所述的結果#
這些數字取自自動字幕轉錄稿中對投影片的朗讀,講述時間為 2025 年末,談的是 2022 年的論文——數值約略,且應歸於講座而非論文本身。
- 模型:GPT-J,一個 6B、開源重現 GPT-3 的模型。短暫暖機、固定學習率,以及固定次數的外層迴圈;每一輪增加內層步驟次數(論文自己的說法是:訓練起步要慢,再逐步加速)。
- 資料集:GSM8K(約 9k 道小學程度的文字題)、CommonsenseQA(選擇題形式的日常推理),以及合成的多位數算術資料集。
- CommonsenseQA是合理化發揮效用的地方:講座給出的正確率約為 72.5%,所用資料量約為直接微調所需資料的 86%。讓人工評分者比較 STaR 推理與少樣本種子推理後,他們認為兩者「相當合理」——這是質化檢查,不是測量結果。
- GSM8K 則沒有這種效果。「使用合理化實際上並未改善表現」——直接用優質資料微調也能達到相近結果。講師將原因歸於難度:模型未經提示時採用的計算步驟數,已經接近合理化步驟提供的數量;因此,對模型能力範圍內的問題,推理引導沒有額外幫助。
- 迴圈會停滯。「這不是真正的 RL……如果反覆執行多輪,過一陣子就會開始停滯。」論文沒有解決應執行多少輪才有用,這仍是調校問題。
**本段轉錄中有個數字不可信。**ASR 將 STaR 與監督式微調的比較記成「math benchmark」達到 51.7——同一場講座約四十分鐘後,DeepSeekMath 的 MATH 分數也被報為相同數字。應視為投影片內容串錯,而非 STaR 的結果;本頁沒有任何論點依賴這個數字。
它在設計空間中的位置#
講座將 STaR 放在 RL 分類法之中,而非與 RL 並列:「幾乎可以把它稱為一種離線強化學習技術」——若最終答案正確就給 1 分,否則給 0 分,離線套用到一批生成結果上。相鄰方法各自在一個面向上有所不同:
| 方法 | 生成方式 | 獎勵 |
|---|---|---|
| STaR | 離線、單次生成,再微調 | 最終答案正確給 1 分,錯誤給 0 分 |
| 線上拒絕微調 | 線上,依目前的策略生成 | 最終答案正確給 1 分,錯誤給 0 分 |
| Group Relative Policy Optimization (GRPO)(GRPO) | 線上,每個提示生成一組結果 | 群組正規化優勢 |
這個排序也是講座解釋後來的方法為何勝出的論據:「如果執行線上強化學習迴圈,並從目前的模型取樣,效果就勝過我們早先在 STaR 做的事。」關鍵差異不在演算法有多複雜,而在於資料是否來自你目前正在更新的模型。
講座提到的兩個後繼方法#
轉錄稿對兩者都只用一句話帶過,本頁也不多做延伸:
- V-STaR——在迴圈中加入一個驗證器,與生成器一同訓練,而不是只靠最終答案是否匹配來篩選。這是對上述假設 1 的直接修補,也連結到課程第 2 至第 3 講討論的驗證文獻。
- Quiet-STaR——將推理移出詞元空間,透過 MLP 在潛在空間中思考:「既然模型可以在內部思考,為何還要讓它用英文表達?」請參照不可見推理(填充詞元潛在計算),本知識庫在該文探討這種做法的代價——思維鏈不再能作為可讀的稽核紀錄。
它的界限#
講座把問題交給全班討論,而非直接回答;學生的答案與講師的看法一致:
- **無法跳出基礎模型的分布範圍。**合理化只能產生「與訓練內容同一層級」的推理鏈,無法創造模型原本無法完成的邏輯步驟。這是課程持續探討問題的具體、小規模版本——迴圈究竟增加了能力,還是只呈現預訓練早已包含的內容?
- **少樣本格式偏差。**種子推理的風格會傳遞到模型生成的所有內容,也會影響所有用來訓練模型的資料。提示工程因此成了訓練資料的決策。
- **不評估推理過程。**沒有人工或 PRM,就無法對推理鏈品質進行爬山式優化;迴圈只能讀取最終答案。
講座還提出一個界限,但沒有定論:有學生指出,實務上只要直接使用前沿模型生成推理資料,就不必從正在訓練的模型開始自我引導。講師同意這個說法有道理——「你隨時可以採用更強大的模型並使用它的輸出,這就像蒸餾」——並捍衛 STaR 作為從零開始的案例:有趣的版本是不存在更強教師模型的情況;只有這個版本能說明自我改進,而不只是壓縮。
停滯有了機制上的解釋:多樣性崩塌(Multiagent Finetuning,2025)#
課程在結課講座回到本頁討論的迴圈(CS329A Self-Improving AI Agents — Part 9: Future Research Areas、Aakanksha Chowdhery,2025-12-05 授課,practitioner-opinion),並提出第 6 講尚未提供的診斷。停滯的主因並非基礎模型的能力範圍、合理化管道或過度擬合,而是生成結果開始變得彼此相似。
Chowdhery 對這個機制的說明最有參考價值,因為她談的是預訓練多樣性的來源,而非觀察曲線:
當你觀察預訓練規模的模型訓練時,資料之所以如此多樣,是因為它是在很長的時間裡由人類生成的……但單一大型語言模型為一組提示生成輸出時,即使在高溫度下,回應也不會很多樣。
因此,單一模型的自我訓練迴圈同時壓縮並收窄一個分布,表現提升「幾輪或幾十輪之後就會停止」。這與第 7 講從取樣角度描述的上限相同——如果取樣量增加 10 倍,但沒有得到更多元的解法,就不會有進步——只不過這次問題出現在訓練時間,而非推論時間。
解法是由同一個基礎模型微調出一群模型。《Multiagent Finetuning: Self-Improvement with Diverse Reasoning Chains》(Subramaniam、Du、Tenenbaum、Torralba、Li 與 Mordatch——MIT / Google,ICLR 2025)將群體分成兩種專家角色,並以不同資料訓練:
| 角色 | 訓練資料 | 任務 |
|---|---|---|
| 生成代理(×N) | 自己產生且符合多數決的輸出,以提示/回應 SFT 配對形式呈現 | 產生多樣的初始解法 |
| 評論代理 | 答案起初錯誤、經過多輪修正的辯論軌跡 | 學習比較正確答案與錯誤答案 |
每輪的結構是一般的多代理辯論,只做了一項調整:每個生成代理下一次作答時,會以其他所有代理回應的摘要為條件(由模型摘要,或直接串接);評論代理評論的是摘要後的整組回應,而不是個別代理的推理鏈;最後以多數決結束該輪。重複這個過程,生成的軌跡便成為下一輪兩種角色微調所用的資料。
投影片呈現的內容——一個座標軸是負對數概似,作為表現的代理指標;另一個是嵌入差異度,作為多樣性的代理指標;兩者都依微調迭代次數呈現,涵蓋三種開源模型(微調要求開放權重;講者稱 Llama 3 的反應最明顯)。單代理微調的表現趨平或崩塌時,多代理微調仍能持續進步,而且回應持續保持差異,沒有逐漸趨同。領域內測試是數學;相鄰領域測試則是 GSM8K,微調後的代理也在該測試中進步。講師提醒,絕對數值已經過時(「這是稍早的研究,所以數字沒有那麼高」),本頁不引用其中任何數字。
論文之後有三點值得保留:
- **測量工具比方法更重要。**將嵌入差異度與正確率並列,是任何自我訓練迴圈都能採用的低成本持續讀值;而 STaR 自己討論停滯時,恰恰缺少這種工具。若迴圈的正確率趨平且差異度下降,代表它遇到的問題與差異度維持穩定的情況不同。
- 實務上早就在用較簡單的替代方案:不做微調,改用不同提示從不同模型生成內容。講師親自將這稱為直觀的替代方式,因此論文真正較狹義的主張是:可以從單一基礎模型製造專業化,而不必付費使用多個模型。
- 多數決是課程中最弱的選擇器。「只要有多個代理,就幾乎免費得到多數決」——而第 2 講測得多數決在 10–50 個樣本時便趨於停滯,且結構上無法看見一萬個答案中只出現一兩次的答案。被買到的是多樣性;負責選擇的機制,則是課程其他地方已證明無法觸及困難尾端的機制。講座沒有將這兩張投影片放在一起討論。
移除最後一項人工輸入:自行提出任務(Absolute Zero,2025)#
STaR 需要一個大型問題/答案配對訓練集——只有存在答案,篩選器才有用。本頁提到的每種方法都承襲了這項依賴;結課講座的第三篇論文則將它移除。
Chowdhery 提出的動機是供給問題,而非成本問題:監督式學習需要人工整理的推理軌跡;具有可驗證獎勵的 RL 需要專家整理問答配對——「如果是 IMO 題目,你就需要 IMO 專家」——而且**當模型超越人類專家的程度後,能撰寫下一道題目的人才供給就會耗盡。**這是將資料障礙視為自我改進上限,而非預算項目的說法。
Absolute Zero(Zhao 等人,2025——講座提醒「還很新」,而且「目前還不常使用」)讓單一模型以程式碼提出並解決任務,因為直譯器可以免費驗證結果。任務分為三類,以(程式、輸入、輸出)三元組表示:演繹(產生程式與輸入,由環境執行程式取得輸出)、溯因(講座對此類任務的描述受到 ASR 影響,聽起來與演繹完全相同——預期的差異應是從程式與輸出反推出輸入;此處是推論,並非引述),以及歸納(抽取一段既有程式,產生新輸入與函數的自然語言描述,再由環境判斷)。
有兩項機制超越了這篇論文的範圍:
- 可學習性獎勵。每個提議的任務都交給解題器:成功率為零時,獎勵為零;成功率非零時,獎勵為1 − 平均成功率。簡單與不可能的任務都得不到分數,因此提議器會因解題器有時成功、有時失敗的任務而獲得獎勵;隨著解題器進步,它也必須提出更難的任務。提議器與解題器「有些對立,但整體而言會互相幫助、一起進步」——這是一套會隨目前權重調整、並自行重新生成的課程。
- 防止提議器鑽漏洞的有效性閘門。只有環境執行過提議任務後,任務才會加入訓練:包括程式完整性錯誤、安全檢查,以及確定性檢查(相同輸入重複執行,必須產生相同輸出)。獲接受的三元組會存入附有各任務成功統計的任務緩衝區;提議器會從緩衝區抽取參照內容,並明確以過去生成的範例為條件,藉此促進多樣性——這與前面的多代理章節採取相同的防止崩塌做法,只是在單一模型內實現。
講座所述的結果(ASR 未保留任何圖表;以下都是講座歸納的質化結果):在程式設計基準測試達到最先進水準,完全沒有使用人工整理的提示資料,表現超越使用數萬個專家範例訓練的模型;訓練過程中複雜度指標與程式/答案多樣性都持續上升,提議器也逐漸提出更難的任務;只用自行提出的程式任務訓練,仍在數學基準測試中表現強勁;大型模型的進步幅度比小型模型更大。
本頁補充三種解讀:
- **人類依賴只是往上移了一層,模式並未改變。**STaR 受限於答案的提供者;Absolute Zero 則受限於驗證器的提供者。只要環境能執行程式,問題就能免費生成——這是以訓練資料供給、而非能力為主題,重新陳述可驗證性論點。
- **遷移結果是講座中同一模式的第三個案例。**Mirhoseini 當場指出這一點,並提到她自己的 SWiRL:「我們看到一種很明確、反覆出現的趨勢,涉及模型生成合成資料以及泛化」——此處是程式→數學;SWiRL 中是計算機→搜尋引擎;SPRINT 中是數學→倒數與 GPQA;前述多代理論文中則是數學→GSM8K。四篇論文,一項主張:自我生成資料能遷移的是推理方式,而非任務或工具。
- **而規模因素不支持對飛輪最有趣的解讀。**兩位講師分別指出,大型模型更能吸收這類資料飛輪的效益——這是 Absolute Zero 自己的結果,也得到 Mirhoseini 從 SWiRL 的 RL 角度獨立佐證。因此自我改進是規模的補充,不是替代品;這正是《苦澀的教訓》出現在原本要繞過資料壁壘的方法之中。講座沒有報告自行提出課程的 pass@K,所以第 6 講提出的界限——RL 提高的是 majority@K,而非 pass@K——在此尚未檢驗,並未遭到推翻。
將篩選器拆成三個問題(2026 年 9 月)#
本頁持續提出的主張是:STaR 的篩選器是整個領域沿用的假設——答案正確就保留推理鏈。2026 年 9 月的 RSI 調查(arXiv 2609.11873,§3.4,practitioner-opinion)檢視自我對弈與任務生成的後繼方法,並將文獻經常混為一談的這項假設拆解成三種性質:
- 有效性——經驗是否正確?可執行檢查與形式化證明助理,能在其支援的範圍內確認這點(Absolute Zero 的程式執行器、STP 的證明檢查器、PSV 對照規格進行的形式驗證)。
- 難度——對目前的學習者而言,難度是否適切?基於一致性的代理指標可以估計難度,但不能證明正確性:R-Zero 的 Challenger 會獎勵多個 Solver 回應之間的不一致;VisPlay 的 Questioner 則會鎖定多數答案信心接近指定中點的問題。
- 學習價值——用這項內容訓練能否帶來持久效益?目前沒有任何方法測量這點。
調查中值得記住的一句話是:**「正確性與估計難度,兩者單獨都無法證明邊際學習價值。」**STaR 的篩選器回答問題(1),並假設(2)和(3)隨之成立;Absolute Zero 的可學習性獎勵回答問題(2),並假設(3)成立。另有兩個佐證:PSV「報告稱,目標難度為簡單、中等、困難的問題,其實際難度高度重疊」,因此依難度提出問題只能部分控制課程,而非精確控制;而一致性代理指標「可能反映歧義或答案不一致,也可能反映有益的難度」。
調查也為本頁停滯討論所圍繞的失敗模式命了名。經驗腐化——「有缺陷的經驗或回饋扭曲後續學習和資料取得決策的風險。」誤導性的難度代理指標會偏好不合適的任務;不準確的評判器會獎勵錯誤行為;由於這些影響會寫入參數,腐化也會在多輪中傳播,並改變下一輪提出的任務。多樣性崩塌是其中一條途徑;校準良好但資訊不足的課程則是另一條,從損失曲線看來,兩者完全相同。
調查提出的控制方式成本低廉,卻沒有人採用:將資料取得機制輸入的學習者狀態固定在較早期的檢查點,或將自適應選取改為不依賴學習者的排程,同時保持資料來源存取權與資料取得加學習的總預算相同。明確指出不能採用的控制方式:讓取得的樣本完全相同,因為這「會移除正在研究的分布自適應本身」。只要以任一控制組對照 Absolute Zero,就能回答學習者條件化究竟有沒有超越增加訓練詞元之外的作用——這是預算配對的質疑進入自我訓練文獻之中。
相關連結#
- RSI 自主性階層(B0–L5)——此迴圈及其後繼方法在 2026 年 9 月 RSI 階梯中的位置:STaR 是 L1(問題、篩選器與輪數都由人類提供);只有在學習者自身狀態決定下一步提出什麼內容時,後繼方法才達到 L3——Absolute Zero 的可學習性獎勵是調查列舉的 L3 範例。前述篩選器的三分法出自該文的 L3 章節
- CS329A:Self-Improving AI Agents(Stanford)——第 6 講的第一篇論文,也是課程核心主張的最小可行示例;結課講座則以本文前述兩種 2025 年的後繼方法重新探討
- Multi-Agent Collective Intelligence——Multiagent Finetuning 在此作為一項研究結果,而非一種方法:透過微調分化的同質群體,正好補上該文專業化問題一直缺少的研究案例(該文其他來源中的工作者都完全相同,或只以提示加以區分)
- 遞迴式自我改進——這個飛輪的 2022 年原型,權重會變動,但人類仍選擇領域、種子推理與迭代輪數
- 流程與結果獎勵模型——STaR 欠缺的工具:未經篩選的合理化步驟,就是第 3 講用來說明流程標籤重要性的結果監督偽陽性
- 離線多步驟工具使用 RL(SWiRL)——三年後從另一側處理同一個缺口,並加以測量:結果篩選只保留模型原本就會解決的內容,因此 RL 中流程篩選優於結果篩選
- Group Relative Policy Optimization (GRPO)——講座分類法中的後繼方法:沿用相同的 1/0 正確性訊號,移至線上執行,並以群組相對優勢取代硬性篩選
- Large-Scale Test-Time Compute——被篩選的樣本來源;STaR 展示了將涵蓋率用在訓練資料、而非答案上的情況
- Effective Compute Scaling——資料壁壘的解讀:這是「將測試時搜尋結果蒸餾回模型」的具體機制,其上限取決於基礎模型,而非計算預算
- 弱驗證器集成——當單一驗證器不夠時,V-STaR 的「加入驗證器」分支會走向的方向
- 不可見推理(填充詞元潛在計算)——Quiet-STaR 的潛在推理分支所付出的代價:推理不再存在於可讀詞元中
- Aakanksha Chowdhery——講師;第 6 講由她主講
- 《苦澀的教訓》——結課講座將這個概念套用到兩個 2025 年的後繼方法,卻沒有繼續探討:大型模型更能吸收自我改進飛輪的效益,這點分別由 Absolute Zero 與 SWiRL 提出。原本為繞過資料壁壘而設計的方法,最後仍顯示其效益隨規模提升
- 軌跡內平行規劃(SPRINT)——四篇課堂論文中,第三篇呈現相同遷移模式:自我生成的訓練資料能提升其他任務與工具的表現,因此飛輪主張的是推理方式,而非某項基準測試
- 資料壁壘與驗證公地是同一項供給限制——本頁的三項結果(停滯、多樣性崩塌、Absolute Zero 移除問題集)被用作本知識庫衡量合成資料能否超越資料壁壘的答案,也點出兩種供給問題交會之處:Absolute Zero 自己的動機——「如果是 IMO 題目,你就需要 IMO 專家」,而且當模型超越人類專家程度後,供給便會耗盡——正是認知公地論點進入訓練方法講座之中
- 提交預算下的選擇——課堂直接提到 STaR 的地方。有人問如何將推理嵌入模型,而非在推論時搜尋推理;學生建議以所用演算法標註訓練解答,講師則指出合理化做法:把答案當作提示交給模型,要求它產生能推導出答案的推理
待解決的問題#
- STaR 不會篩選合理化後的推理鏈;講座提出的補救方式是在步驟 3 加上 PRM。對附有答案提示的推理過程進行流程篩選,是否能以可測量的方式改善迴圈?還是只會讓訓練集縮回模型原本就能解決的問題,正好回到合理化試圖填補的缺口?
- 迴圈在執行幾輪後「開始停滯」,而講座並未說明原因。停滯是因為基礎模型的能力範圍(沒有新問題進入能力範圍)、合理化管道將看似合理但錯誤的推理鏈引入訓練集,還是對有限的基準測試訓練切分產生一般性的過度擬合?第 9 講(2025-12-05 授課)部分回答了這個問題,提出原問題未列出的第四個可能原因,以及前三者都沒有的測量方法:單一模型的生成結果會「即使在高溫度下」逐漸趨同,造成多樣性崩塌,使接連幾輪持續壓縮愈來愈窄的分布。多代理微調的證據來自兩條曲線的變化,而非消融實驗:在單代理微調表現趨平或崩塌時,對專業化群體進行微調,仍能持續提高正確率,而且嵌入差異度會維持在高點**,而非逐漸下降。這讓多樣性成為直接影響結果的變數,也提供一個低成本的持續診斷方式(將差異度與正確率並列),用來區分這個原因與其餘三項。問題仍未完全解決:比較的是群體與單一代理,而非成因分解;沒有任何實驗組固定多樣性,同時改變基礎模型的能力範圍;而且數字是透過 ASR 朗讀投影片取得,講師也稱論文已過時。
資料來源#
- The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement — Duan、Liu、Tang、Chen、Zhou 等人(35 位作者;SJTU / Theseus Labs / Tsinghua / ByteDance / ModelBest / Xiaohongshu / Shanghai AI Lab / Humanlaya / Agent-Native Research Lab / Frontis.AI),arXiv 2609.11873,2026-09-10,79 頁(
practitioner-opinion)。本頁只引用 §3.4:有效性/難度/學習價值的區分、各系統對學習者條件化資料取得的檢視(SSP、AZR、R-Zero、STP、PSV、VisPlay、VOYAGER、SIMA 2、SEAgent)、經驗腐化風險,以及兩種提議中的消融實驗。次級來源——本知識庫未收錄上述原始研究;PSV 難度重疊數字是調查報告中的描述,並非直接讀取論文所得。完整討論見RSI 自主性階層(B0–L5) - CS329A Self-Improving AI Agents — Part 6: Train-Time Scaling and Scaling RL — Stanford CS329A 第 6 講,Train-Time Scaling and Scaling RL(由 Aakanksha Chowdhery 單獨授課,2025-10-10 授課、2026-08-03 發布,
practitioner-opinion,YouTube 自動字幕轉錄,約 13k 字)。講座三篇論文中的第一篇:推理資料問題、生成/篩選/微調/重複迴圈、合理化步驟及其未經篩選的狀態、三項明確假設、GPT-J 在 GSM8K/CommonsenseQA/算術上的結果、停滯、對 V-STaR 與 Quiet-STaR 的簡述,以及課堂對此方法限制的討論。論文本身不在raw/中——所有圖表數字都來自 ASR 朗讀投影片,其中一個歸於 STaR 的 51.7 已在上文標示,很可能是投影片內容串錯。與第 2 至第 5 講不同,這篇論文沒有講師作者身分衝突 - CS329A Self-Improving AI Agents — Part 9: Future Research Areas — Stanford CS329A 第 9 講,Future Research Areas(兩位講師共同授課,2025-12-05 授課、2026-08-03 發布;
practitioner-opinion,前瞻部分屬於prediction等級;YouTube 自動字幕轉錄,約 10.5k 字)。結課調查中的第一與第三篇論文:Multiagent Finetuning(Subramaniam 等人,ICLR 2025)用來討論多樣性崩塌診斷、生成器/評論者角色分工及其兩種訓練資料、搭配摘要的辯論輪次結構、負對數概似與嵌入差異度投影片,以及 GSM8K 相鄰領域測試;Absolute Zero(Zhao 等人,2025)則用來討論專家供給動機、演繹/溯因/歸納任務類型、1 − average success rate可學習性獎勵、程式完整性/安全/確定性有效性閘門、任務緩衝區與多樣性條件化,以及程式→數學的遷移和規模相依主張。兩篇論文都不在raw/中,ASR 也未保留可引用的圖表數字——因此上文兩節都刻意只做質化描述。本文使用時標示了一項轉錄瑕疵:溯因任務的描述與演繹完全相同。兩篇論文都不是講師所著;講師的利益衝突位於效率部分(推論效率即能力)
Cited by 19
- The Data Wall and the Validation Commons Are One Supply Constraint×7
The plateau has a named mechanism, and it is distributional. Multiagent Finetuning (ICLR 2025, via…
- Aakanksha Chowdhery×4
Training prompts are statically curated by human experts · Absolute Zero — Rationale Bootstrapping…
- CS329A: Self-Improving AI Agents (Stanford)×4
Reasoning chains stop being diverse, so the loop plateaus · Multiagent Finetuning (MIT/Google, ICLR…
- Multi-Agent Collective Intelligence×3
Do homogeneous LLM collectives produce real synergy, or only humans-with-human-limits benefit from…
- Effective Compute Scaling×2
The concrete mechanism behind "test-time-search outputs distilled back," and its actual ceiling.…
- Large-Scale Test-Time Compute×2
Two things keep this from settling the question. It is one paper's ablation on maths, recounted…
- Open Questions Backlog×2
Rationale Bootstrapping Self Training: The loop "starts to plateau" after a few iterations and the…
- RSI Autonomy Levels (B0–L5)×2
The defining property is learner-conditioned future experience acquisition: evidence about the…
- Compute-Controlled Benchmarking
Rsi Autonomy Levels — this page's charge extended twice by a September 2026 RSI survey. Its §3.3.4…
- Group Relative Policy Optimization (GRPO)
Rationale Bootstrapping Self Training — the predecessor in the lecture's own taxonomy: STaR is the…
- Inference Efficiency as Capability
Rationale Bootstrapping Self Training — the same lecture's other half, and the reason the two sit…
- Intra-Trace Parallel Planning (SPRINT)
Rationale Bootstrapping Self Training — the same transfer shape from a different payload, and one…
- Invisible Reasoning (Filler-Token Latent Computation)
Rationale Bootstrapping Self Training — the deliberate version of the same trade, proposed in 2024…
- Model Capability & Training
Rationale Bootstrapping Self Training — The 2022 ancestor of every self-improvement loop that moves…
- Offline Multi-Step Tool-Use RL (SWiRL)
Rationale Bootstrapping Self Training — the 2022 statement of the same hole, attacked from the…
- Process vs Outcome Reward Models
Rationale Bootstrapping Self Training — the same false positive, four years earlier and with no…
- Selection Under a Submission Budget
Rationale Bootstrapping Self Training — the class's own answer to "how do we embed reasoning into…
- The Bitter Lesson
Rationale Bootstrapping Self Training — the lesson arriving inside the method built to escape it:…
- Weak-Verifier Ensembling
Rationale Bootstrapping Self Training — where this page's problem enters the training loop rather…
Related articles
- Large-Scale Test-Time Compute
Noam Brown's thesis that model capability is now a function of inference budget (tokens/cost/time): with good scaffoldi…
- CS329A: Self-Improving AI Agents (Stanford)
Stanford's graduate course on self-improving agents, taught by Azalia Mirhoseini and Aakanksha Chowdhery (Autumn 2025,…
- Process vs Outcome Reward Models
The four-year arc of trained LLM verifiers as taught in CS329A lecture 3: OpenAI's GSM8K verifier (score the finished s…
- Latent Capability Overhang
Noam Brown's claim that already-released models can do far more than anyone has extracted, because nobody spends enough…
- RL from Execution Feedback (RLEF)
Train a coding model with the interpreter in the loop: generate code, run a small visible set of public tests, feed the…