資料來源#
- Driving the Agent Quality Flywheel from Your Coding Agent- Google Developers Blog
- Recursive Self Improvement for Coding Agents
- Sidekick's continual learning loop
摘要#
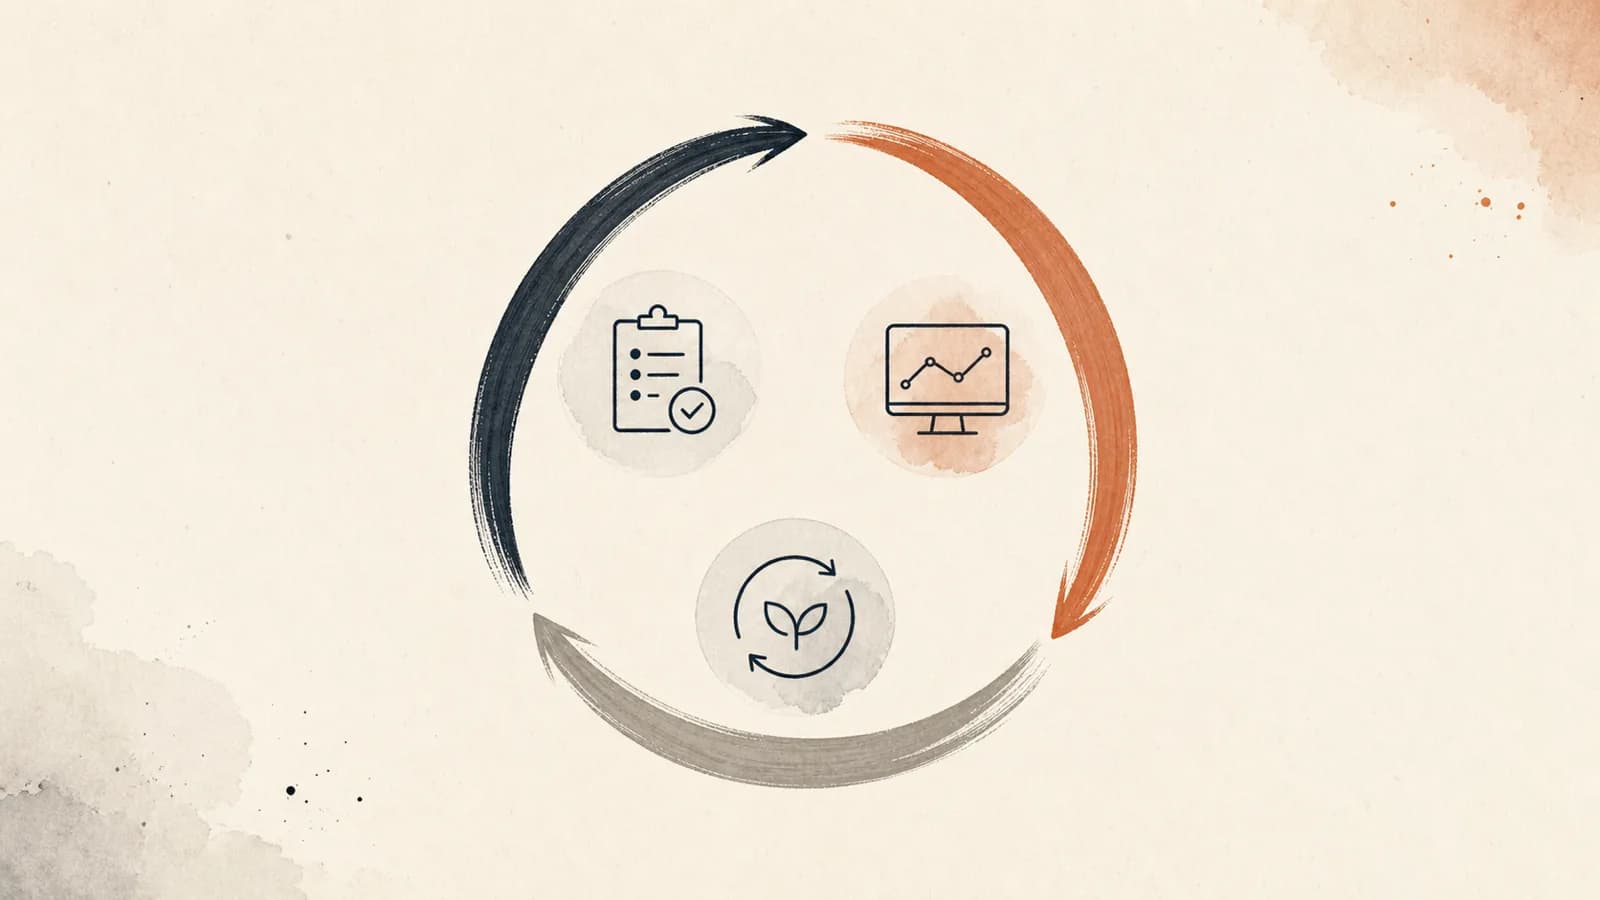
Google Cloud 提出一套以工程方法打造代理程式品質,而非憑感覺檢查的方法,並於 2026 年 6 月以可安裝技能的形式推出,由你的程式碼代理程式驅動。它點出代理程式開發中的日常困境:你調整提示,在三個範例上看起來更好了,卻不知道是否讓另外十個範例變糟——「指標真的改善了,還是只是感覺變好了?」飛輪由三階段循環構成——建置與測試 → 發佈與監控 → 學習與精進——其中「建置與測試」再細分為五個具體步驟,先依序跑過一次,再循環執行(階段 2–5),直到達成品質目標。Google 表示,這套方法與其 AutoRaters,和它用於自家模型及第一方代理程式的方法相同,並由 Google DeepMind 共同開發。來源是第一方產品部落格(vendor-claim):機制描述具體,示範循環也有詳細演練,但結果是 Google 自己的示範,並非獨立測量。
五個階段#
- 準備資料——從現有 OTel 軌跡、手工編寫的案例或合成情境建立評估資料集。
- 執行推論——讓代理程式在資料集上執行並產生軌跡(若軌跡已存在,例如正式環境工作階段,則略過)。
- 評分——使用自適應 AutoRaters(以模型為基礎的評審,會評分軌跡並說明原因)或自訂指標為軌跡評分。唯一每次都會執行的階段。
- 分析失敗——閱讀評分規準的判定,了解案例為何失敗;失敗案例達十個以上時,使用 Automatic Loss Analysis 將其分群。
- 最佳化與迭代——套用有針對性的修正,重新執行 2–4,並與先前基準比較。
這項技能把一個嚴謹原則寫進流程:多數失敗案例都得經過數輪迭代,指標才會真正改善;也把一條架構規則寫進去:最佳化器絕不評分自己的成果:無論提出修正的是程式碼代理程式、自動最佳化器或人類,都由獨立評估服務評分。
介面:描述一項疑慮,核准一份計畫#
開發者不必碰評估 CLI,也不必指定指標。整個介面就是用白話描述疑慮——「我擔心 travel-concierge 是否會遵從對話中途提出的變更……請想出測試方法並提出計畫」——而技能的工作是把這個目標轉成適當的評估:讀取代理程式的程式碼、挑選指標、合成情境、執行評分,並回報前後差異。這是在自動化評估撰寫:判斷工作往上一層移動,從撰寫評估變成說出疑慮並核准計畫。
在 Google 的實作示範中(以 ADK 建置的多代理程式旅行規劃器),這項技能透過 User Simulator 針對五種修訂類型建立 25 個情境,使用兩個內建多輪 AutoRaters 和一套專門設計的分類評分規準評分,發現 21% 的修訂遭到 IGNORED,精確定位出失敗之處;人類核准一項三句的指令修正後,再跑同一項評估,結果從 21% 降至 5%。
把一項疑慮變成穩定指標#
這是示範中最值得借鑑的一課。自適應 AutoRaters 每次執行、每個案例都會重新產生評分規準,因此特定失敗只會成為多項標準之一,再折入綜合分數——失敗確實存在,也有名稱,卻不易察覺:有個案例中,內建任務成功指標給了令人安心的 0.80,但使用者的修訂仍被忽略,因為五項生成標準中有四項通過。問題不在於偵測,而在於隔離。做法是把這項疑慮獨立升格為穩定的自訂指標——此處是 revision_honored,採用分類判定(HONORED / IGNORED / PARTIAL / NO_REVISION)——如此便能計數、設定門檻(「如果超過 20% 的結果是 IGNORED,就採取行動」),並逐輪追蹤趨勢。實際分工是:自適應內建指標作為廣泛的健康度訊號,再用一項穩定指標衡量你正在改變的行為。(延伸閱讀:LLM-as-a-Judge,了解這裡擴充的自適應評分規準做法;以及看似成功的失敗,了解被綜合分數掩蓋的失敗類型。)
沒有假設也能運作#
只給一個問題分類代理程式一句 「找出真實失敗並修好它」,這項技能就會廣泛探索——採用多樣的合成情境和內建多輪指標——並自行找出主要失敗群:15 個案例中有 14 個,代理程式雖然正確完成工作,卻沒有告訴使用者自己呼叫了哪些工具(它自己的指令明明要求這麼做;模型卻悄悄把它當成選擇性要求)。依 Google 的示範,一段修正說明讓工具揭露率在一輪內從 0% 提升到 96%。「這是我的目標」和「幫我找問題」都能作為起點。
兩種節奏:開發循環與正式環境循環#
- 按需執行(開發):尚無真實使用資料 → User Simulator 合成情境。這明確是冷啟動引導:「合成情境讓你能開始;正式環境資料才會讓循環變得精準。」
- **持續執行(正式環境):**同一項技能直接使用真實 OTel 軌跡——已完整的軌跡會跳過「執行推論」,直接以相同評分器評分。Online Monitors 持續評估即時流量,並將品質分數寫入 Cloud Monitoring;分數一旦偏移,失敗軌跡就會進入同一個評估-修正循環。每個正式環境中的失敗,都是下一輪循環可直接使用的測試案例——將正式環境來源的評估落實為產品循環,而非基準測試。
Google 表示,未來將讓技能自行驅動更多外層循環——監看監控器、找出回歸、提出修正——但目前仍是由它提出、人類核准;推出的版本刻意不採自主運作。
有人已經照著這個方向做了。Cline 在 2026 年 7 月的專案(代理程式撰寫的 harness 最佳化,case-study)讓整個五階段流程無人值守地執行 17 小時——基準執行、分析失敗軌跡、針對性修正、再次執行、決定保留或捨棄——人類只需按下繼續並檢視最後的 PR。相較於飛輪規格,兩項差異值得記住:最佳化對象是 harness 原始碼,而非代理程式指令;評分器是固定基準測試,而非獨立評估服務,因此最佳化器能寫入自己的評分基礎,這項不變條件靠提示中的條款維持,而非架構設計。
同一個飛輪,把循環閉合到權重中(Shopify,2026 年 8 月)#
Andrew McNamara & Cody Mazza-Anthony(Shopify Engineering,2026-08-05,case-study)以同一個名稱描述同一套循環,並在 Shopify 的 GraphQL Sidekick 代理程式上正式環境運作——這是一個面向商家的代理程式,會對商店撰寫並執行 Admin GraphQL API 查詢,每分鐘最多處理 2,000 個請求。閱讀時請先考量 COI:這是 Shopify 自己描述自家系統,沒有外部複現、沒有對抗性審查,所有數字均由其自行回報。其來源層級高於 Google 的 vendor-claim 文章,低於資料集中每一筆 empirical 來源;若與測量結果衝突,以測量結果為準。
**階段的標準清單以圖表為準,而非文章文字。**文章的「飛輪循環」圖列出六個階段——01 Ground Truth Set(「建立一組規格作為 ground truth」)→ 02 LLM as a Judge(「讓 LLM Judge 與人類判斷一致」)→ 03 Frontier Model MVP(「使用 frontier models 快速打造 MVP」)→ 04 Data Collection + Self-healing(「收集正式環境資料並擷取難例負樣本」)→ 05 Model Training(「微調開放權重模型」)→ 06 Gist Compression(「把系統提示壓縮為 Gist tokens」)——中央的 Flywheel Optimization Process 節點再回饋至 01。文章正文的 ## 標題則是另一份較粗略的清單,把 04 和 05 合併為一節,並將 autoresearch 放在圖表中 MVP 的位置;原始檔保留兩種排序,本文以圖表為標準。
與 Google 飛輪在結構上的差異,是循環在哪裡結束。Google 的 Learn & Refine 將失敗軌跡交回程式碼代理程式,由它修補指令後重新執行;改變的成果是提示。Shopify 先做同樣的事,但把改進開始不再有成效的時點視為循環的起點而非終點——原文如此寫道:*「一旦 harness 改進停滯,我們就開始在參數空間中最佳化。」*他們對問題的描述,是資料集中最精確的說法:「部署後的 frontier model 是凍結的,因此改進只能累積在周邊的離散成果中:提示修改、檢索範例、路由規則和 harness 程式碼。正式環境知識在文字和程式碼中不斷堆積,模型權重卻始終未變。」Shopify 每輪循環都從更好的模型開始;Google 每輪則從更長的提示開始。這是一項關於應先把哪個改進對象做到極限的排序主張,依據來自正式環境而非基準測試——也是資料集中唯一這類主張(參見以知識為核心的自我改進,了解它如何排序各種改進對象;以及代理程式撰寫的 harness 最佳化,了解 harness 透過另外三種途徑也會抵達同一個停滯點)。
階段 01–02:先定義品質,再把評審校準至人類能達到的上限#
文章特別指出,這是團隊最容易匆忙帶過的步驟:「定義品質是循環中最重要的一步……它從描述何謂良好開始,最後成為推動學習的獎勵訊號。」具體流程如下:
- 一份包含少數評分標準的評分規準(完整性、執行狀況、回應品質、安全性),每個分數都有具體依據——也就是「產品團隊對好與壞的定義」,以及「所有下游工作的品質契約」。這是把評估當成產品規格的主張,並將其設為正式環境的門檻。
- Ground truth 必須包括隨機抽取的流量,而非只有精選範例:「Golden sets 測試的是你已知道要找的案例;隨機樣本則揭示正式環境裡實際的好與壞。」
- 建立任何評審器之前,先設一道評分規準歧義門檻:兩位專家標註者盲標 25 個隨機樣本,並以 Cohen's kappa 衡量標註者間一致性。κ 約為 0.2 時,就判定評分規準有歧義並重寫——「如果每天都在處理這項產品的幾位專家都會被評分規準搞糊塗,LLM 也會。」
- 評審器校準是提示最佳化步驟,而非模型選擇:使用帶有反思式最佳化器的 DSPy(GEPA、Agentic Context Engineering)。
- 校準後進行兩項驗證:用先前的 A/B 測試回測評審器(它能否還原參與度或留存率上已知成敗的方向?),以及執行針對性的退化測試——刻意破壞一項行為,確認相應標準,而且只有該標準,分數會下降。
- 讓評審器保持小型且具針對性,不要把所有產品行為塞進同一個評審器,「因為聚焦的評審器能讓這些測試更容易解讀。」這與本文提出的「把一項疑慮升格為一項穩定指標」原則不謀而合。
最關鍵的數字只出現在圖片裡。Judges' agreement 圖(標題是「即使專家也無法完全一致」)顯示人類一致率 = 83%,並註記「完美:無法達成」;旁邊的評審器為 80%,略低於此數字——兩者都沒有出現在文章正文。這套說法正是 LLM-Judge Validation 所支持,而 MVVP 未涵蓋的:「一致率就是評審器的上限……目標不是做出『完美』的評審器,而是讓它與人類的一致程度,大致等於人類彼此的一致程度。」誠實的補充是,上限比較採用的是原始一致率,沒有校正偶然一致;儘管同一團隊在前一段才用 κ 設定評分規準門檻——參見該文,了解為何 83% 和 80% 正是其 Finding 1 所指出會被高估的指標。
階段 03:autoresearch,以及宣告結束的停滯點#
在碰觸權重之前,Shopify 先讓 frontier-model MVP 在「不碰權重」的前提下盡可能提升,而且是由代理程式而非人工操作。對於提示微調不足以解決問題,文章的解釋相當精確:系統「已經是正式環境中的應用程式,動態組合提示、自訂控制循環,以及專門設計的協調程式碼散布在大型程式碼庫裡。沒有任何單一提示能決定其行為……最佳化目標是整個 harness:提示、工具定義和協調程式碼。」
這個循環採用 Karpathy 式 autoresearch——提出修改、根據校準後的評審器評估、分數提升就保留,否則捨棄——所有設定都放在一份易讀的 program.md 中。其 Environment 區段授予修改 prompts/、tools/ 和 harness/ 的權限,並註明「這裡的所有內容都能修改,包括 harness」;實驗指南則寫道:「小幅、精準的修改,一次一個想法……優先採用最簡單的變更;任何造成退步的修改都要復原。」這條路徑的完整說明、另外五個案例及其矛盾,請見代理程式撰寫的 harness 最佳化。
階段 04:自我修復流程將失敗擷取為訓練訊號,而非測試案例#
這個階段在 Google 的循環中沒有對應項目。系統從匿名化的正式環境流量中擷取難例負樣本——「評審器正確判為低分、並揭露模型弱點的對話」——每個案例都進入修復流程:
- 由一組frontier reasoning models各自獨立分析失敗(圖中三位評論者分析一段評分為 2/5 的對話,提出:「工具用錯,透過查詢 schema 重試」、「漏了分頁,抓取所有頁面」、「答案漏掉使用者要求的欄位」)。
- 仲裁器把評論整合成一條修復指令。
- 在使用者回合之前注入這條指令——「有時稱為『提示引導』」——並從該處重播對話。
- 評審器重新評分重播結果。通過 → 重播結果成為 RL 軌跡,評審器分數作為獎勵。失敗 → 升級交由人工標註(由 Toloka 的專家標註者依據校準評審器時使用的同一份評分規準評分)。
接著分兩階段訓練:先在完整軌跡上蒸餾至較小的模型,包含產生答案的推理過程(而非只有最終答案),再以校準後的評審器作為獎勵訊號執行 GRPO。整個流程每天執行,微調採「針對累積資料進行全參數微調」——新軌跡加上先前所有軌跡——因為「同時以新舊軌跡訓練,可以限制每輪循環間的偏移和災難性遺忘。」
有兩點值得留意。此時評審器同時擔任離線指標、難例負樣本篩選器、修復門檻以及 RL 獎勵——同一個校準工具肩負四種職責,但原始一致率為 80%,人類上限是 83%;而且整份說明中,沒有任何地方在最佳化器持續對它進行最佳化時重新驗證它。不依賴參考答案的評審器過度給分衡量的正是這種失敗:同一個未改動的評審器在最佳化前有效,最佳化後卻無效。再者,升級交由人工的路徑,表示流程的整體吞吐量受限於人工標註,而這些正是評論者無法修復的失敗——最棘手的那一批。
蒸餾曲線是文章中最值得引用的內容#
GraphQL Distillation 圖是文章唯一報告規模與表現關係的地方;和評審器一致率圖一樣,數字都沒有出現在正文。圖上標示的軸為:x 軸「Dataset Size」(10k–70k),y 軸「Judge Score」(60–76),上升曲線上標出六個點:
| 資料集大小 | 評審器分數 |
|---|---|
| 13k | 61.5 |
| 26k | 64.5 |
| 30k | 66.7 |
| 39k | 68.5 |
| 46k | 70.7 |
| 61k | 73.5 |
圖上有兩條虛線參考線,只標示名稱,沒有印出數值:**「Production baseline」約為 65.8,以及「Frontier reference baseline」**約為 73.1(兩者都是從座標軸讀取)。曲線在 26k 到 30k 條軌跡之間越過正式環境基準;只有在測試的最大資料集大小 61k 時,才抵達 frontier 參考基準。
請仔細解讀曲線頂端,因為文章的標題主張就建立在它之上。圖表標題是 Distillation——只涵蓋 SFT 階段,尚未進行 GRPO——而且最後一個資料點僅超過 frontier 參考基準 0.4 個評審器分數;圖中沒有誤差棒、隨機種子或信賴區間。因此,文章的核心品質主張(「SFT 和 RL 讓專用模型的表現超越 frontier model」)拆開來看,測得的 SFT 曲線只達到相當水準,而未繪圖呈現的 GRPO 階段則被宣稱能進一步超越。這個主張合理,曲線也確實能說明樣本效率;但圖表並未證明「超越 frontier」這件事。
階段 06:gist 壓縮,以及它實際帶來的效益#
最後一個階段降低的是服務成本,而非提升品質。長篇靜態系統提示是「每個請求都必須支付的延遲和服務成本固定稅」,而 gist 壓縮能刪去其中大部分:教師模型保留完整提示、學生模型使用一小段學習得到的 gist token embeddings,讓模型權重保持凍結並訓練嵌入以符合教師模型的輸出分布,最後部署學生模型。Shopify 回報,提示從約 6,000 個 token 降至約 1,500 個,而且「評審器測得的品質沒有損失」。
所有效果都是 Shopify 自行測量,測試使用每分鐘 350 個請求的負載:首個 token 產生時間降低 約 19%、端到端延遲降低 約 38%、吞吐量增加 約每秒多處理 16% 的請求,以及每秒多輸出約 12% 的 token;使用相同 GPU 時,換算為「相同流量約可少用 14% 的 GPU」。這是對同一筆成本稅的另一種處理方式,提示快取經濟學對其成本有所估算——快取讓靜態前綴再次讀取時成本更低,gist 壓縮則讓它更短——比較詳情請見該文。
文章自己的彈出說明也承認,這是推估而非帳單上的實際支出。原文如下:「以 frontier model 提供這些流量服務,根據平均 token 成本,預估每年可能輕易花費 2,700 萬美元。微調後的模型成本可能只要其中一小部分,接近 100 萬美元:服務成本降低 96%。」兩個數字確實出自來源,但都是依據「平均 token 成本」推算的反事實估計——Shopify 從未以每分鐘 2,000 個請求的流量,連續一年執行 frontier 設定;也沒有公布每個請求或每項任務的分母,因此 96% 是兩個模型推算的年度總額之比,不是測得的節省金額(每項任務成本高於每個 token 成本一文長期指出的問題換了形式:百分比有公布,單位卻沒有)。也請留意估算沒有納入的項目:每日全參數微調、frontier 評論者群組、仲裁器、重播流程,以及 Toloka 標註合約,都是運行飛輪時反覆產生的成本,卻沒有列在比較的任何一方。
第 1 階段之前的一步(Shankar,2026 年 7 月)#
五個階段從準備資料開始,到第 4 階段的失敗分析為止——此時技能會「閱讀評分規準的判定,了解案例為何失敗」。這是在既有分類系統上分析:評分規準已經列出標準,第 4 階段解釋案例觸犯哪一項。Shreya Shankar 的演講談的是先於全部五個階段的上游步驟——在撰寫任何評分規準之前,先找出失敗模式是什麼——她主張,自動化流程無法接手這一步,原因在於認知而非工具:何謂「良好」存在開發者腦中,不在軌跡裡。
兩種說法並不像表面看來那麼對立,兩者的接縫正是本文自己的介面。飛輪的輸入是一項白話描述的疑慮——「我擔心 travel-concierge 是否會遵從對話中途提出的變更」——這正是已經外顯化的一部分開發者判斷。Google 將那句話之後的一切自動化;Shankar 的流程則負責產生那句話,而她主張沒有工具能代替你產生它。冷啟動示範(「找出真實失敗並修好它」)是飛輪唯一聲稱能在沒有明確疑慮的情況下找出問題的案例,也正是 Shankar 的反對意見最有力之處:工具揭露失敗群是容易辨識的失敗——代理程式自己的提示裡明確寫了指令,模型卻沒遵守。依定義,品味相關的失敗不會寫在提示裡。
兩方的共識更值得關注:人類負責核准而非執行,代理程式提出的內容則一次一項地作為建議,由人類決定接受或拒絕。Shankar 把界線再收緊一格——她的代理程式會把人類的標註套用到其他軌跡上,但不會被要求擴展分類系統,因為驗證代理程式的品味,比表達自己的品味成本更高。
它是什麼、又不是什麼#
**它是:**在你的程式碼代理程式中執行的方法與協調流程——選擇指標、呼叫評估服務、閱讀判定、提出修正、比較前後結果。以技能形式發布(npx skills add …,兩個套件搭配同一個評估服務)——方法論和組織脈絡以相同單位交付,系統化格式跨越不同廠商。**它不是:**自主系統(有人參與迴圈);ground truth 的來源(AutoRaters 雖然精密,仍以模型為基礎——應將分數視為方向性指標,相較任何絕對數字,更相信不同次執行間的差異);真實流量的替代品。
相關文章#
- 最佳化器與評估器解耦——飛輪最關鍵的架構規則;提案者和評分者保持分離
- 看似成功的失敗——兩個示範循環都找出的失敗類型,也是軌跡層級的評分規準評分勝過快速瀏覽輸出的原因
- LLM-as-a-Judge——AutoRaters 是評審器原語的自適應評分規準版本;飛輪再加上把疑慮升格為穩定指標的原則
- 正式環境來源的評估——正式環境的執行節奏:以真實軌跡作為評估輸入,明確以合成模擬啟動冷啟動
- 把評估當成產品規格——這項技能將產品經理工作往上自動化一層:人類說出疑慮並核准計畫,技能負責撰寫評估
- Loop Engineering——把評估-修正循環包裝成原生於產品的技能;Google 加入 Codex/Claude Code 行列,將循環原語納入產品
- 代理式工作系統化——以技能作為交付單位;此處承載的是廠商方法論,而非組織專屬脈絡
- Compounding Loop Optimization——同一套為每個重複步驟配置工具的原則,產品化後用於代理程式開發的評估-修正步驟
- 驗證成為新的瓶頸——此工具要解決的瓶頸:讓評分、失敗分析和回歸比較便宜到足以反覆執行
- Gemini Enterprise Agent Platform——技能負責協調的平台,其評估服務、User Simulator、Online Monitors 和 AutoRaters 都來自這裡
- Google DeepMind——AutoRaters 的共同開發者
- 動態工作流程:代理程式的代數——在探索階段沒有人工參與的飛輪:Bun 在合併後執行受涵蓋率引導的模糊測試器,自動提交由 Claude 撰寫、能重現並修復問題的 PR(執行 100B 次解析器測試 → 約 15 個 PR),人類只審查輸出
- 代理程式撰寫的 harness 最佳化——Google 表示刻意尚未推出的外層循環自主版本:同樣五個階段(基準 → 執行 → 評分 → 分析失敗 → 修正),沒有人工逐一核准修正,而且最佳化對象是 harness,而非代理程式指令。Shopify 的 autoresearch 階段是第五個正式環境案例,也是唯一報告停滯點之後發生什麼事的案例
- 以知識為核心的自我改進——列出改進循環可以持續寫入的對象(代理程式、harness、知識、提示);Shopify 的飛輪增加第五項——權重——並決定順序:先把離散成果做到極限,停滯後再轉向參數空間
- LLM 評審器驗證——01–02 階段部分實踐、部分略過的驗證原則:評分規準採用標註者間 κ 門檻、明確以人類上限而非 100% 作為評審器目標、對照線上指標進行 A/B 回測,以及逐項執行退化測試——但上限比較本身回報的是原始一致率,而非校正偶然一致後的數值
- 群組相對策略最佳化(GRPO)——權重更新階段採用的目標函數;此處以校準後的 LLM 評審器作為獎勵,而非驗證器或基準測試評分器,並以正式環境軌跡每日執行
- 不依賴參考答案的評審器過度給分——自我修復流程集中的風險:一個校準後的評審器同時擔任離線指標、難例負樣本篩選器、修復門檻和 RL 獎勵,而且在 GRPO 以它為目標進行最佳化時沒有重新驗證
- 提示快取經濟學——階段 06 要處理的靜態前綴成本,還有另一種做法:快取讓再次讀取前綴成本更低,gist 壓縮則讓前綴更短
- 每項任務成本高於每個 token 成本——2,700 萬美元 → 100 萬美元的推估屬於哪一種情況:公布了百分比卻沒有單位,而且比較雙方都是反事實的年度總額,而非測得的每請求成本
- LLM-as-Compiler Knowledge Base——同一個編譯邊界,只是輸出層從 markdown 換成參數;也是該文所述未來方向最貼近正式環境的實例(以累積素材微調,讓模型把它們學進權重);蒸餾曲線則為這個想法提供資料集大小數字
- 將代理程式工作凝結為工作流程——發現的行為可採用的第三個終點:升格至權重,而非確定性程式碼。harness 上採用相同的證據門檻保留或捨棄循環,但對確定性的影響相反(微調不會帶來確定性,因此沒有降級標準);這也是唯一回報 harness 階段停滯之後發生什麼事的來源
- AI 輔助錯誤分析——第 1 階段之前的一步,以及說明為何這一步仍由人類負責的論證;詳見上文
尚待解答的問題#
- 兩個示範循環都修正了指令層級的代理程式錯誤,並在單輪內帶來大幅改善。若失敗需要變更工具、記憶或架構,循環會如何運作——「指標改善前得先經過數輪迭代」在實務上是否才是常態?
- 自訂評分規準由同一個程式碼代理程式撰寫,而它之後也會提出修正。指標的選擇位於評分之前——解耦是否應延伸至指標由誰定義,而不只是由誰評分?
- 合成 User Simulator 情境啟動了完整的第一輪循環。在真實流量分布中,21% 降至 5% 的改善幅度還能維持多少(也就是正式環境來源的評估所說的代表性落差)?
- 權重空間飛輪真的能勝過它蒸餾而來的 frontier model,還是只能追平?資料集中唯一一條曲線,在測試的最大資料集上僅比 frontier 參考基準高 0.4 個評審器分數,沒有誤差棒、隨機種子或信賴區間,而超越主張則依賴之後未繪圖呈現的 GRPO 階段。可證偽的版本是:以不同隨機種子和信賴區間重做同一組蒸餾掃描,分別回報只使用 SFT 與使用 SFT+RL 的兩組結果,並和 frontier 參考基準比較。
資料來源#
- Sidekick's continual learning loop — Andrew McNamara & Cody Mazza-Anthony,Sidekick's continual learning loop,Shopify Engineering,2026-08-05,
case-study(約 2,100 字,7 張內容圖)。完全屬於第一方 COI:Shopify 自行描述自家正式環境系統,沒有外部複現、沒有對抗性審查,所有數字均由其自行回報。六階段飛輪圖(標準階段標籤)、評分規準/Cohen's kappa/標註者一致性流程、透過 DSPy + GEPA/ACE 進行評審器校準並搭配 A/B 回測與退化測試、program.mdautoresearch 設定、評論者群組 → 仲裁器 → 提示引導 → 重播的自我修復流程、升級至 Toloka、先用完整軌跡進行 SFT 再執行 GRPO、每天針對累積資料進行全參數微調、gist 壓縮與負載測試數據,以及 2,700 萬美元/100 萬美元的推估。有兩個帶數字的圖表未在文章正文出現數據;依圖片兩輪檢視規則直接讀圖:Judges' agreement(人類 83%/評審器 80%,原始一致率)和 GraphQL Distillation(六個曲線點及兩條參考線,軸標籤如上)。完整解析筆記和證據處理方式見wiki/sources.md - Driving the Agent Quality Flywheel from Your Coding Agent- Google Developers Blog — Melnyk & Dai,Google Developers Blog,2026-06-30(
vendor-claim);內容建立在 Cloud Next '26 的代理程式品質演講之上
Cited by 24
- Agent-Authored Harness Optimization×4
It is the only source that reports the loop terminating, and what the team did next. Every instance…
- Evals as Product Spec×4
Agent Quality Flywheel — eval-authoring automated: the coding agent translates a plain-language…
- Production-Sourced Evaluation×4
Agent Quality Flywheel — the continuous product-loop form: OTel production traces graded in place,…
- Crystallizing Agent Work into Workflows×3
Shopify's Sidekick account (McNamara & Mazza-Anthony, Shopify Engineering, 2026-08-05, case-study —…
- Knowledge-Centric Self-Improvement×3
Their loop's ordering is the part with no analogue here: prompts, tool definitions and harness code…
- LLM-as-Compiler Knowledge Base×3
The downstream half of that idea now has a production instance. Shopify's Sidekick account (Shopify…
- LLM-Judge Validation×3
Both are construct-validity instruments, which is precisely the half this page's title says the…
- Agentic Work Systematization×2
A step past org-internal systematization: in June 2026 Google shipped its agent-quality evaluation…
- Dynamic Workflows: An Algebra for Agents×2
Ongoing verification upgraded, which is the durable win: Miri in CI, LeakSanitizer tracking all…
- Failures That Look Like Success×2
The failure class Google's Agent Quality Flywheel write-up puts at the center of agent quality:…
- Gemini Enterprise Agent Platform×2
Google Cloud's platform for building, running, and evaluating agents — in this corpus, the…
- Google DeepMind×2
AutoRaters — the adaptive Llm As A Judge graders at the core of Google Cloud's Gemini Enterprise…
- LLM-as-a-Judge×2
Google's Gemini Enterprise Agent Platform AutoRaters (developed with Google Deepmind; the grading…
- Loop Engineering×2
Two weeks after Osmani's essay, Google supplied the strongest confirmation yet that the loop is…
- Optimizer–Evaluator Decoupling×2
The rule that in any improvement loop, the thing that proposes a change never grades that change.…
- Prompt-Cache Economics×2
Agent Quality Flywheel — the third lever on the same static-prefix tax, treated above: gist…
- AI-Assisted Error Analysis
Agent Quality Flywheel — the same lifecycle from the vendor side, and the sharpest
- Cline
Agent Quality Flywheel — a different discipline than the flywheel's eval-fix loop, but the same…
- Compounding Loop Optimization
Agent Quality Flywheel — the read-feedback/fix step of agent development productized: Google ships…
- Cost-per-Task Over Cost-per-Token
Agent Quality Flywheel — the inverse of this page's complaint, and worth keeping for that reason.…
- Group Relative Policy Optimization (GRPO)
Agent Quality Flywheel — the corpus's only production deployment of GRPO, and the one with the…
- Agent Systems & Harness Engineering
Agent Quality Flywheel — Google's eval-fix loop packaged as a skill your coding agent drives: Build…
- Open Questions Backlog
Agent Quality Flywheel ×4 (oldest 89d) — Both demo cycles fixed agents with instruction-level bugs…
- Reference-Free Judge Over-Crediting
Agent Quality Flywheel — the deployment this page's finding is aimed at, run without the control it…
Related articles
- Optimizer–Evaluator Decoupling
The architectural rule in eval-fix loops that whatever proposes a fix (coding agent, automated optimizer, human) never…
- Open Questions Backlog
Generated by `_system/lint.py --write-backlog`. Do not hand-edit. Domain and Watching sections carry one row per page —…
- Cost-per-Task Over Cost-per-Token
Anthropic's inverted model-selection default: start with the most capable model and dial effort down — a stronger model…
- Harness Shrinkage as Models Improve
Prompt scaffolding shrinks each model release; Cat Wu's pruning discipline; Boris Cherny "100 lines of code a year from…
- LLM-as-a-Judge
Using one LLM to grade another's outputs against criteria/rubrics; DRACO's protocol is per-criterion binary MET/UNMET +…